
A IBM apresentou o LLMON no Granite 4.1, uma forma experimental de estruturar o contexto enviado a modelos de linguagem. A proposta separa explicitamente instruções, dados, requisitos e saídas, em vez de deixar o modelo deduzir o papel de cada trecho. Isso importa para agentes de IA, sistemas com busca em documentos e automações que misturam comandos com conteúdo externo.
O lançamento inclui dois modelos de prévia, com 3 bilhões e 8 bilhões de parâmetros, derivados dos modelos base Granite 4.1. A empresa também abriu um repositório com ferramentas, conversores e exemplos. A própria IBM ressalta que a tecnologia está pronta para exploração e avaliação, mas ainda não para produção.
Como o LLMON no Granite 4.1 organiza o contexto
LLMON significa LLM Object Notation. A linguagem usa marcações semelhantes às de XML, mas seus delimitadores são tokens especiais reservados no vocabulário do modelo. Cada bloco pode indicar se um trecho é uma instrução, um dado, uma exigência ou o local em que a resposta deve ser produzida.
Um bloco de execução liga a tarefa aos dados e requisitos corretos. Assim, um documento recuperado por RAG pode ser tratado como material de consulta, não como uma ordem. Respostas de ferramentas, mensagens antigas e trechos sem vínculo com a tarefa permanecem no contexto, mas não deveriam receber a mesma autoridade de uma instrução chamada pelo bloco de execução.
Para desenvolvedores, a adoção inicial não exige escrever toda a marcação manualmente. Os modelos trazem um template de conversa que converte listas comuns de mensagens para LLMON. O projeto também oferece conversores entre JSON e LLMON, preservando estruturas aninhadas em blocos identificáveis.
O que muda para equipes que criam agentes
O principal valor prático está em reduzir ambiguidades no contexto. A tabela abaixo resume onde a proposta pode ajudar e o que ainda precisa ser validado.
| Cenário | Possível ganho | Ponto de atenção |
|---|---|---|
| RAG e busca documental | Separa pergunta, regras e documentos recuperados | A qualidade da recuperação continua determinante |
| Agentes com ferramentas | Distingue comandos de respostas e esquemas de ferramentas | Integrações precisam respeitar o template |
| Prompt injection indireta | Reduz a chance de texto malicioso ser tratado como comando | Não é garantia contra ataques adaptativos |
| Dados estruturados | Converte JSON em blocos tipados e endereçáveis | Adiciona uma camada ao pipeline |
Na prática, equipes que hoje acumulam instruções, documentos, histórico e respostas de APIs em um único prompt podem testar uma separação mais explícita. Isso pode ser especialmente útil em fluxos nos quais o modelo recebe conteúdo que a aplicação não controla. O conceito também dialoga com outros projetos de modelos abertos, como o NVIDIA Cosmos 3, embora os objetivos técnicos sejam diferentes.
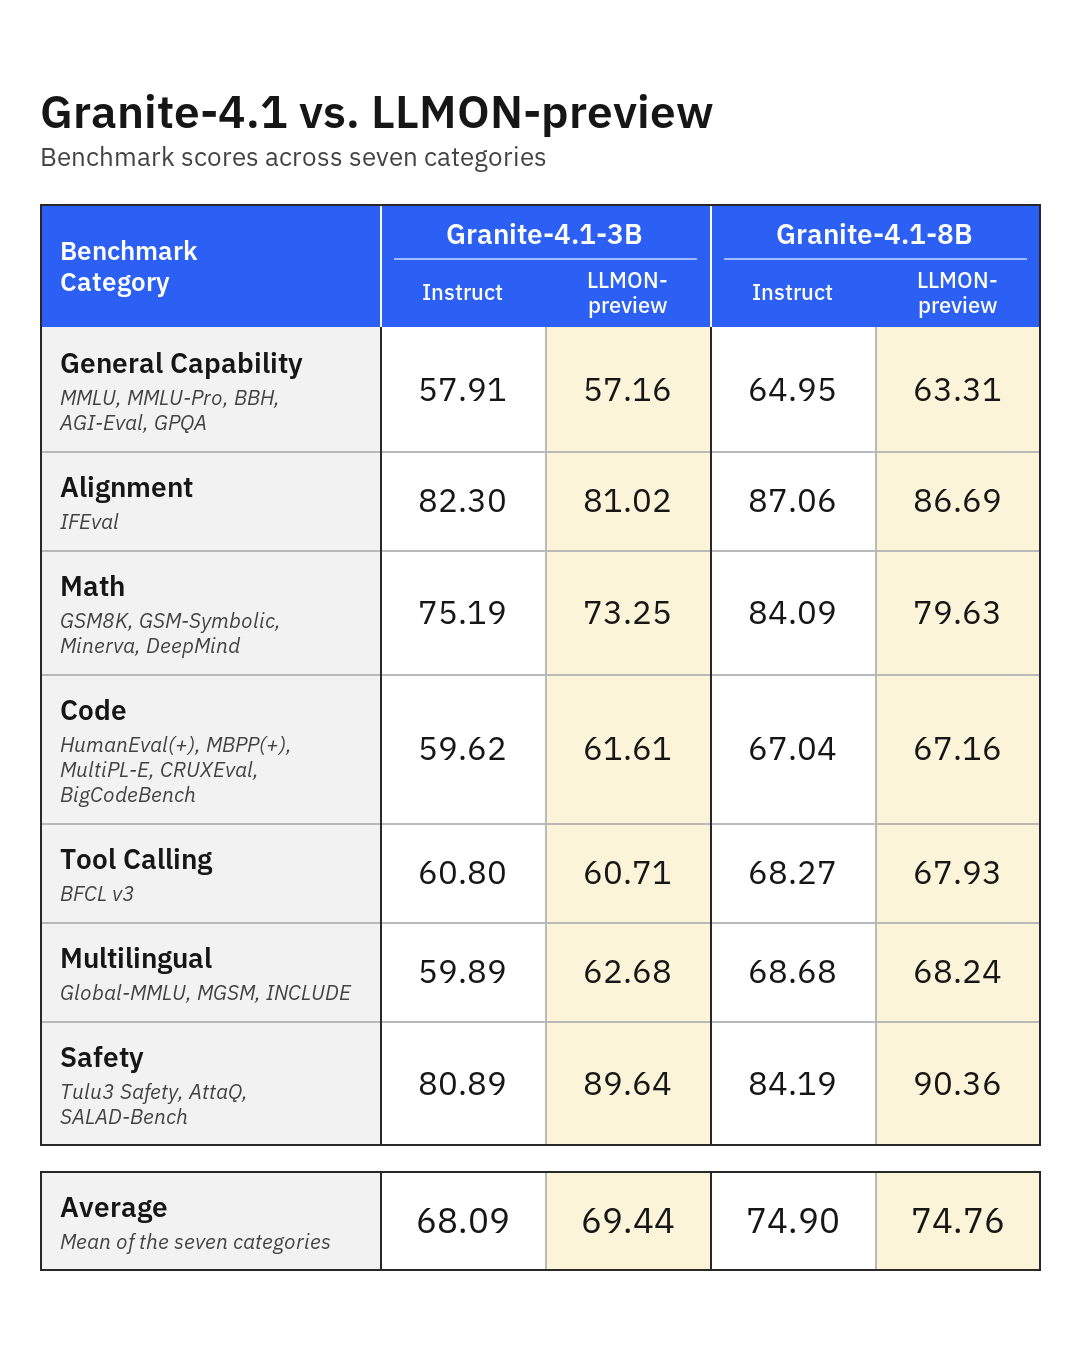
Resultados, limites e disponibilidade
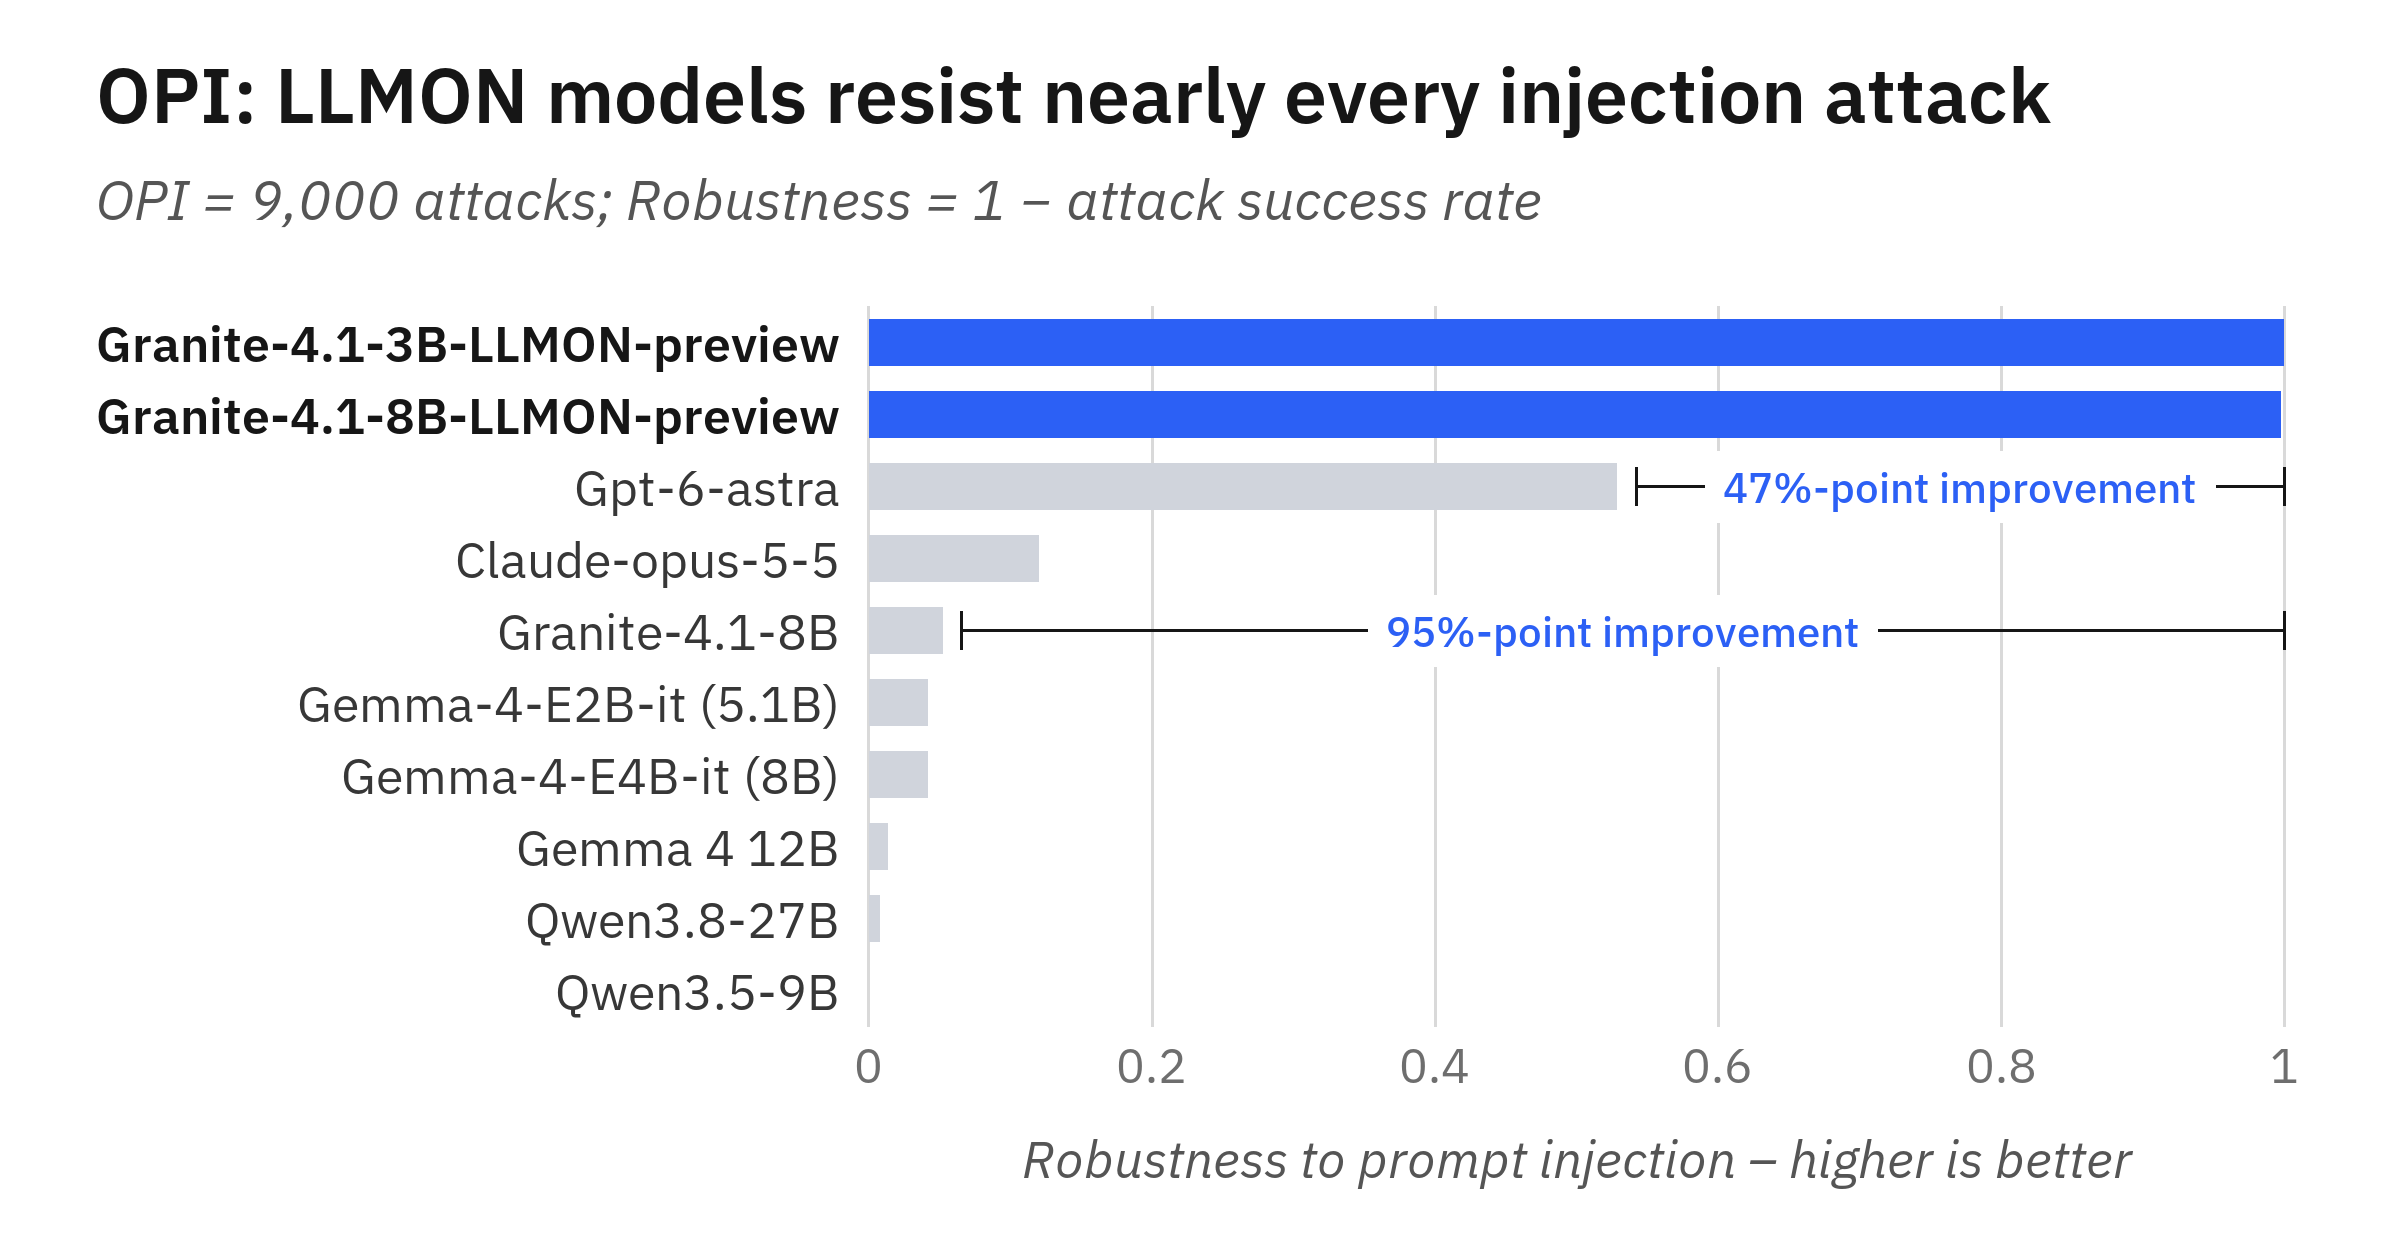
Segundo os testes divulgados pela IBM, os modelos LLMON resistiram melhor a injeções indiretas estáticas no benchmark OPI do que os modelos comparados. A empresa afirma que a abordagem evitou 47% mais ataques que o melhor modelo de fronteira testado e 95% mais que o melhor modelo aberto avaliado. Esses números são resultados apresentados pelos próprios autores e não substituem validação independente em aplicações reais.
O ganho também não deve ser interpretado como solução completa de segurança. A equipe informa que ataques adaptativos, desenvolvidos ao longo de vários turnos, ainda são uma frente de trabalho. Além disso, o comportamento é aprendido durante o treinamento, não imposto por uma barreira técnica infalível.
Os modelos Granite 4.1 3B LLMON Preview e Granite 4.1 8B LLMON Preview estão disponíveis no Hugging Face. O repositório inclui exemplos para extração, RAG, chamadas de ferramentas e ajuste com vocabulários próprios. Para empresas, o passo sensato agora é avaliar a abordagem em ambientes isolados, comparar com prompts atuais e medir segurança, qualidade, latência e custo antes de qualquer uso crítico.


Leave a comment