
O Lumi IA foi disponibilizado no Hugging Face como um modelo de linguagem com cerca de 4 bilhões de parâmetros e foco na geração de texto em português. A chegada importa porque amplia a oferta de modelos menores voltados ao idioma, mas a documentação atual ainda deixa perguntas essenciais sobre treinamento, licença e condições de uso.
O repositório oficial identifica o projeto como CEIA Lumi-4B. Os metadados do Hugging Face registram a criação em 27 de outubro de 2026 e indicam 3.973.556.832 parâmetros em formato BF16. O arquivo de configuração aponta a arquitetura Nemotron-H, 42 camadas e janela máxima declarada de 262.144 posições.
Lumi IA: o que foi divulgado
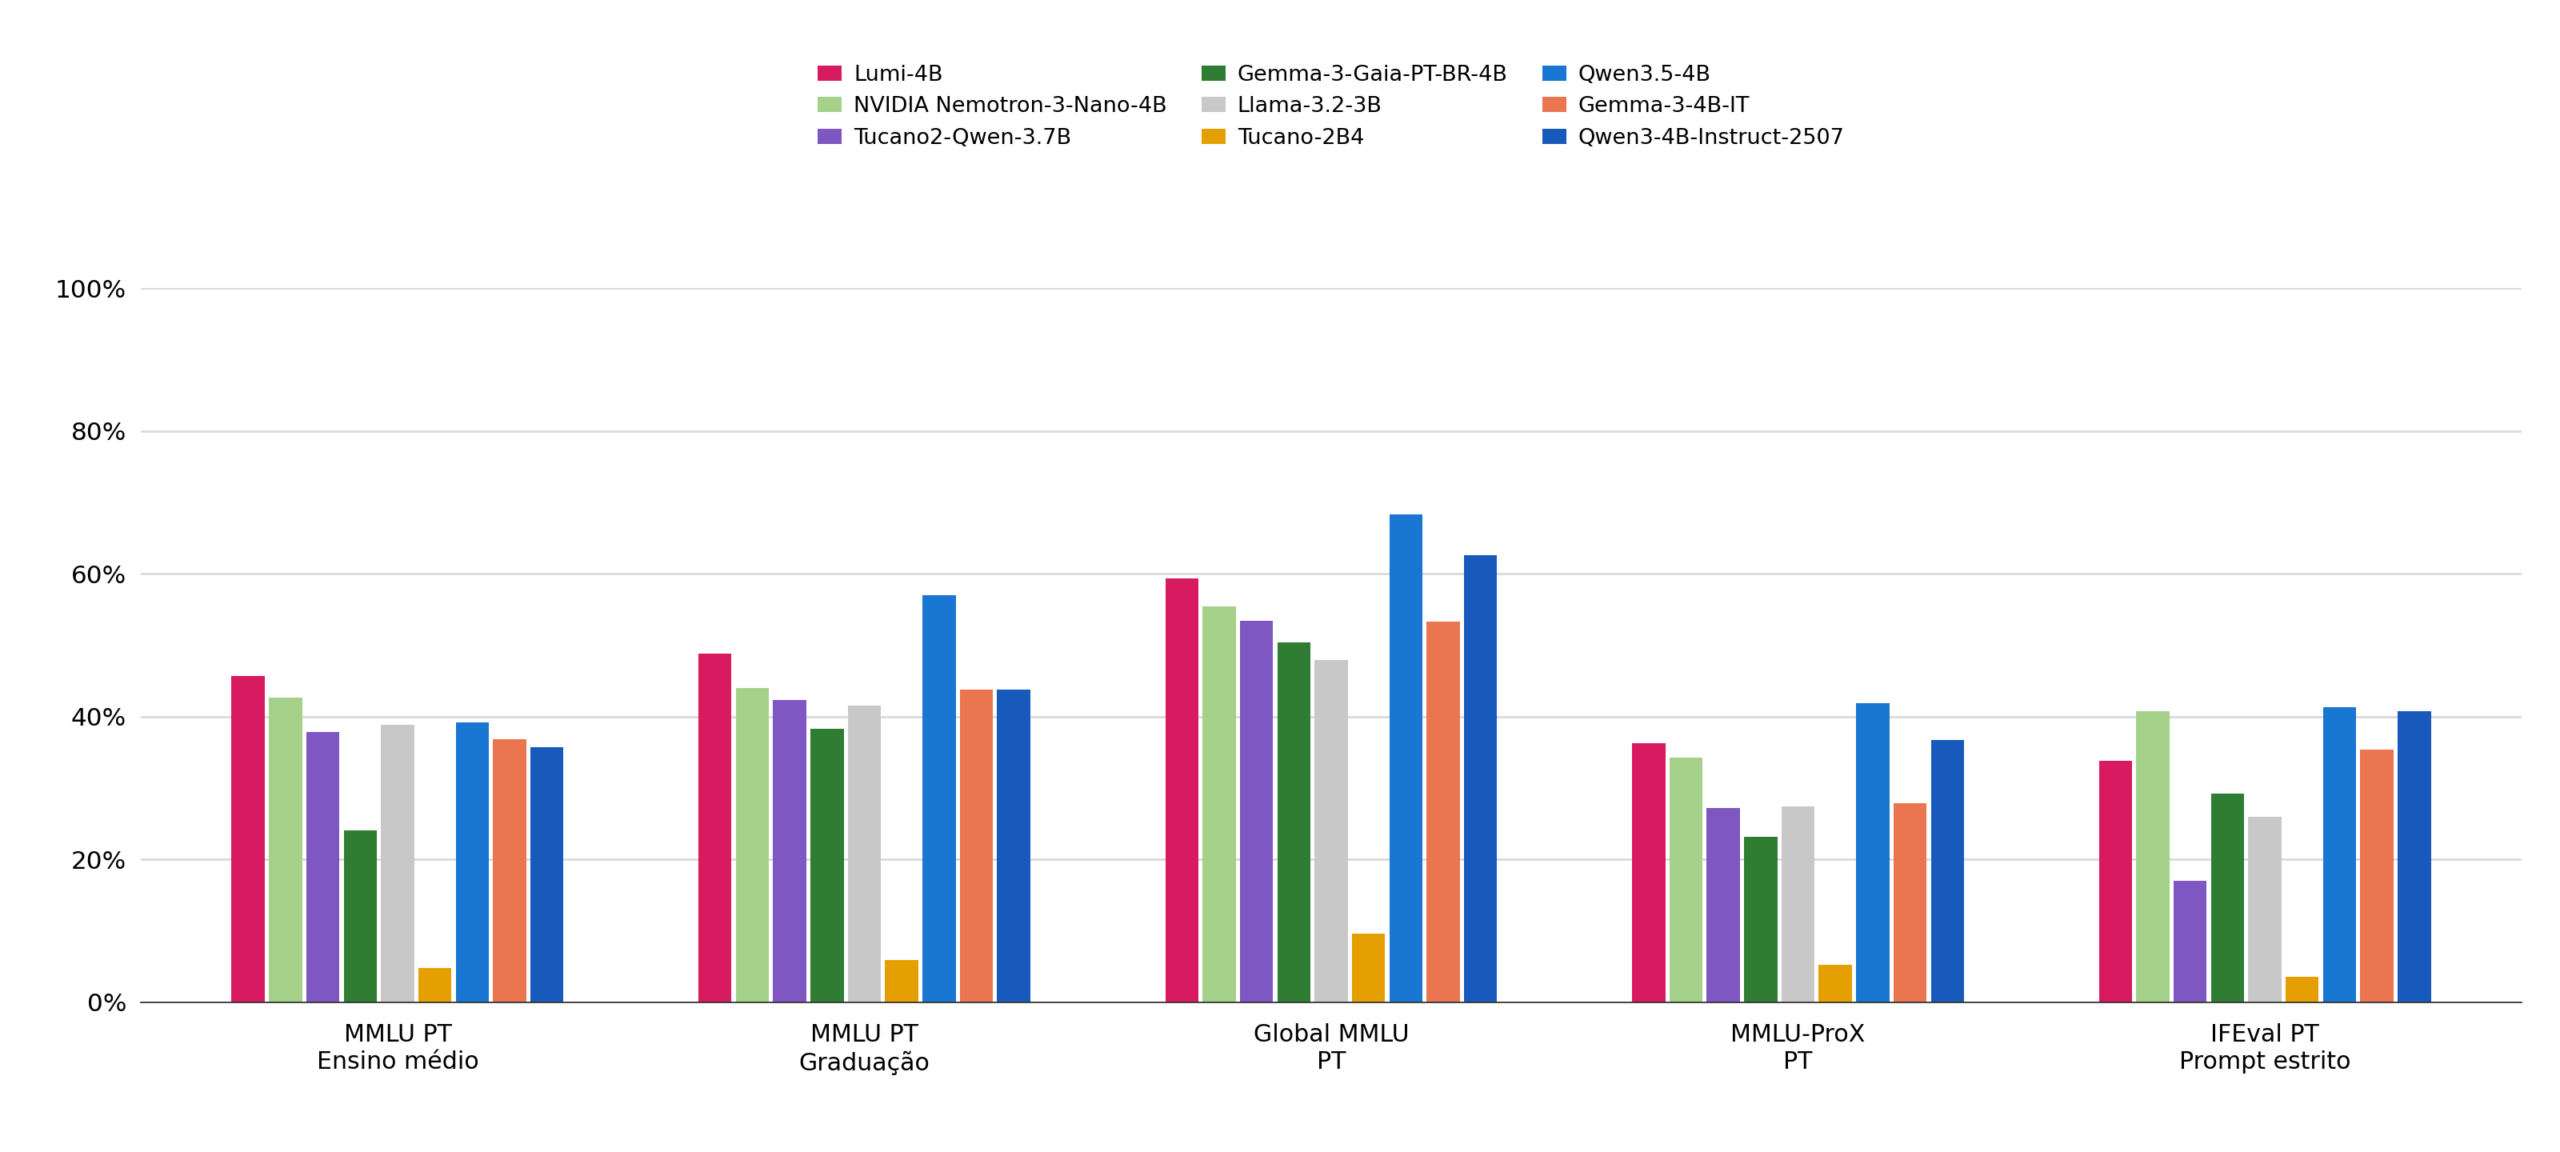
O card do modelo apresenta cinco avaliações em português. O Lumi-4B obteve 45,72% no MMLU PT de ensino médio, 48,80% no MMLU PT de graduação, 59,36% no Global MMLU PT, 36,28% no MMLU-ProX PT e 33,83% no IFEval PT com prompt estrito.
A média simples divulgada foi de 44,80%. Nesse recorte, o Lumi aparece na segunda posição entre nove modelos, atrás do Qwen3.5-4B, que marcou 49,5. O gráfico também inclui variantes de Qwen, Gemma, Llama, Nemotron e Tucano.
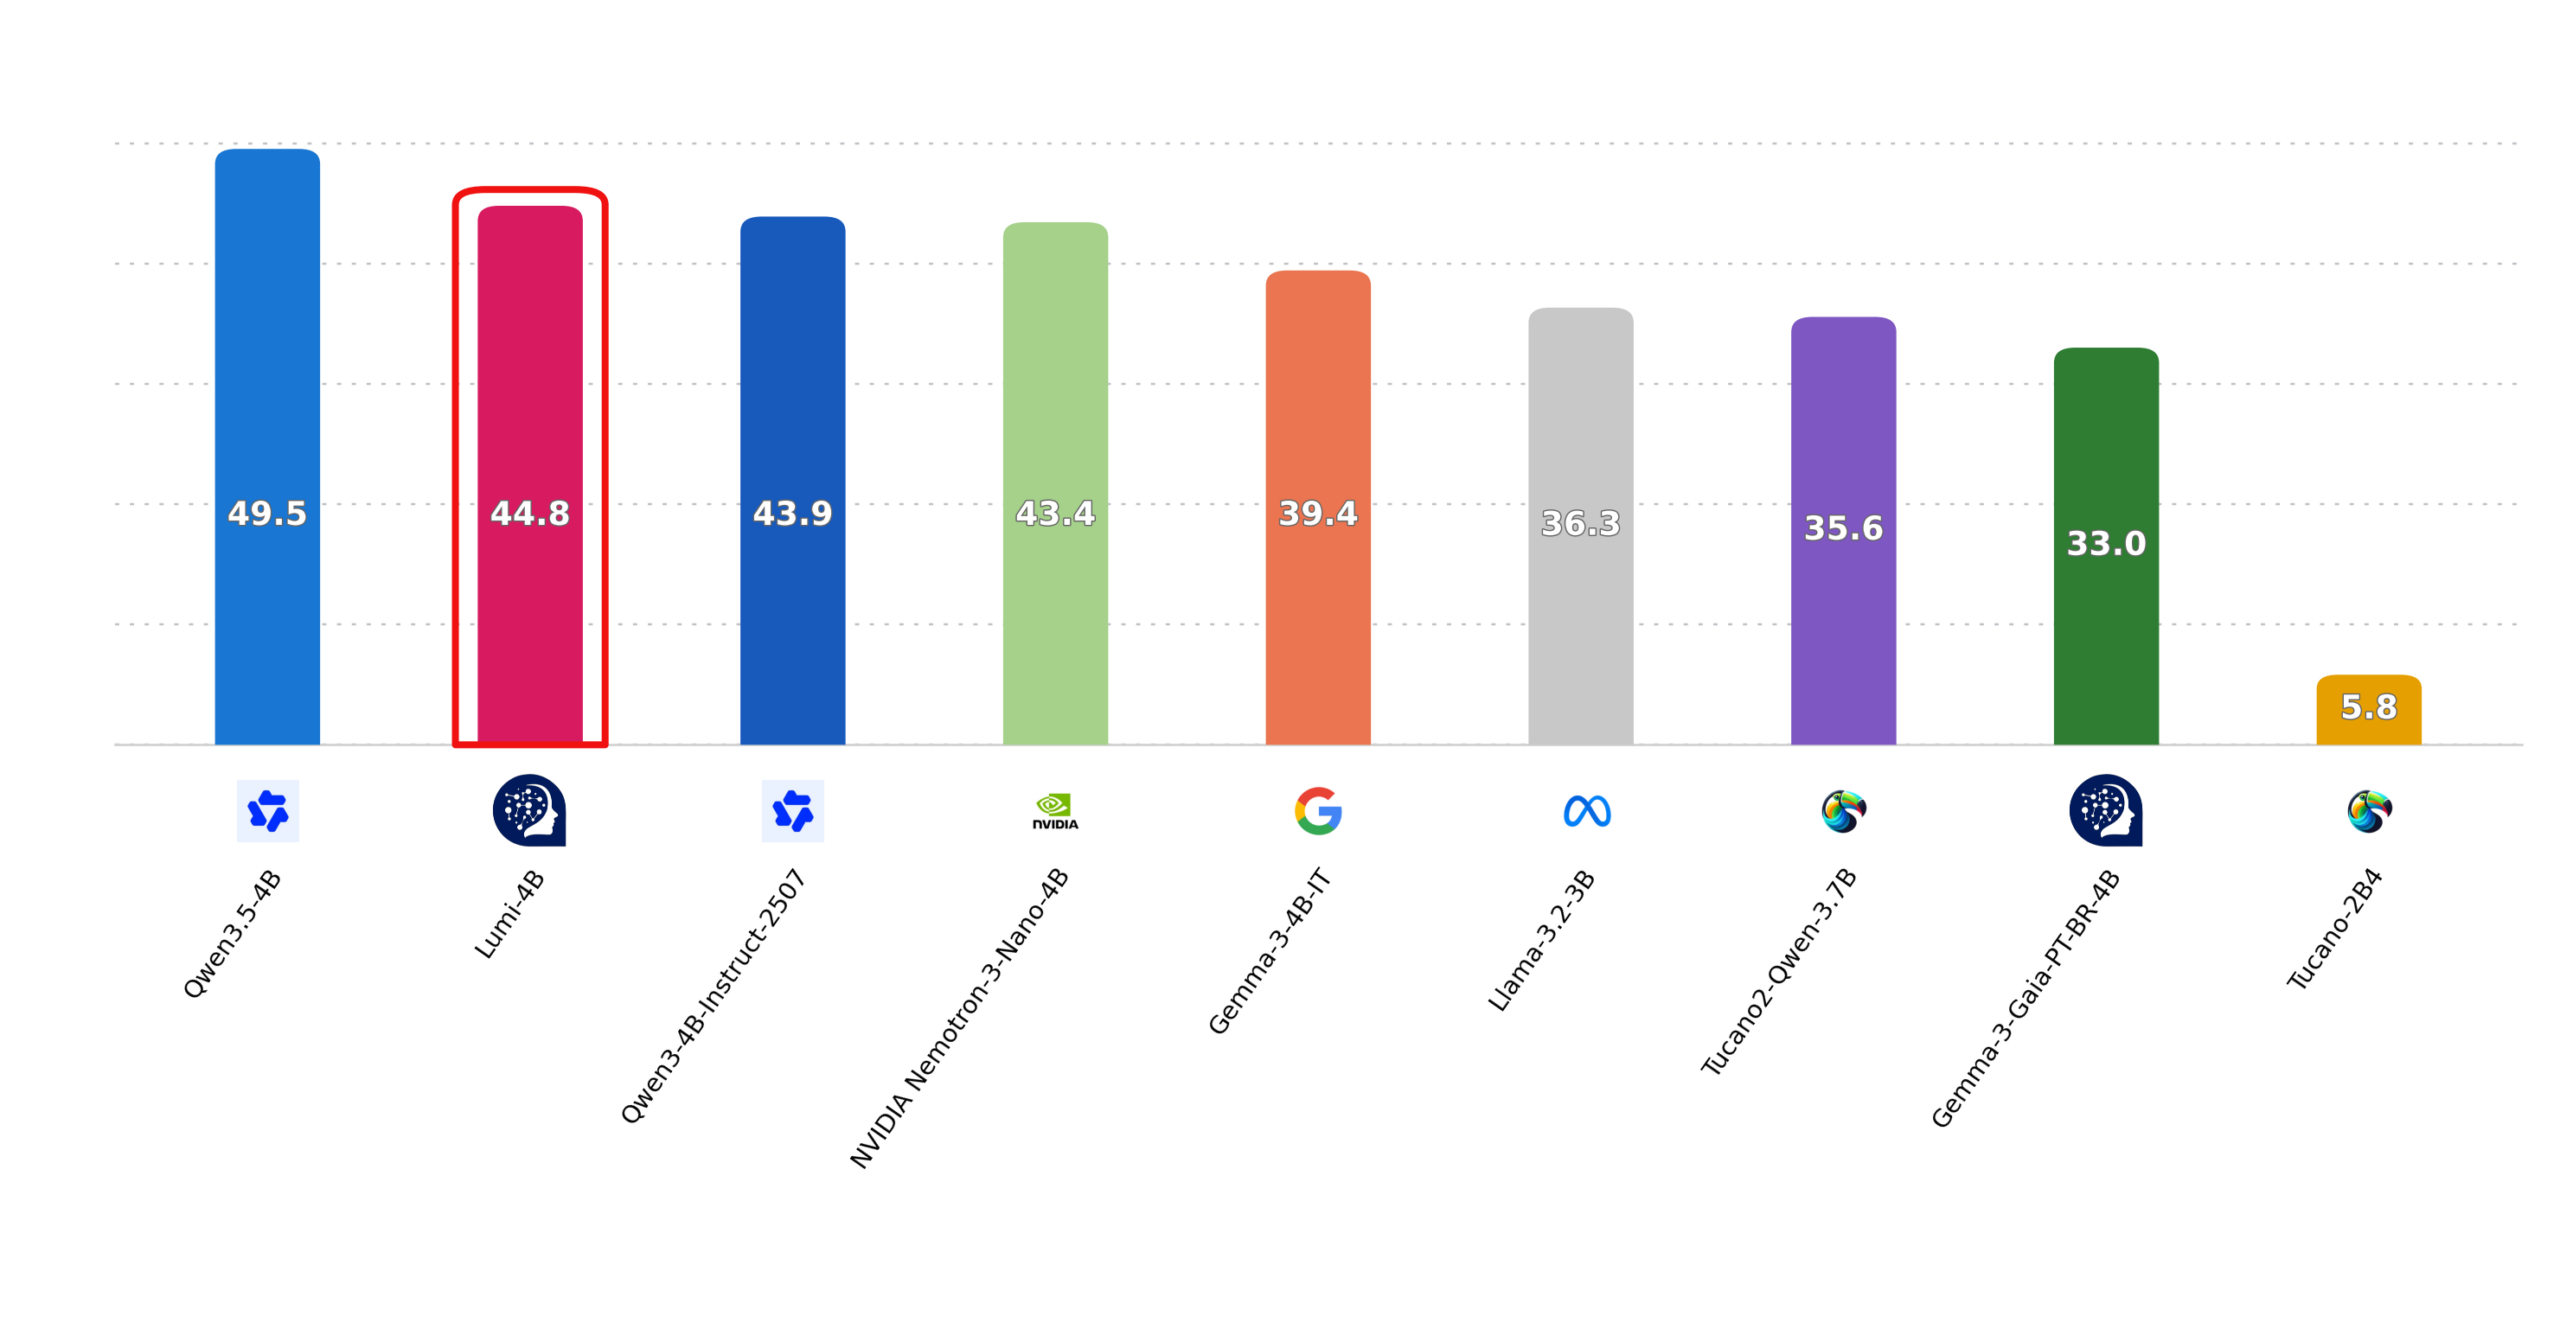
Esses números ajudam a situar o modelo, mas não devem ser tratados como uma classificação definitiva. O próprio card alerta que não informa as versões dos conjuntos de avaliação, o sistema usado para executar os testes, os parâmetros de geração nem intervalos de confiança. Sem esses detalhes, a reprodução independente fica limitada.
Como interpretar os resultados
Benchmarks medem tarefas específicas em condições controladas. Eles não mostram sozinhos como um modelo responde a documentos longos, linguagem regional, textos técnicos, atendimento ao cliente ou fluxos com ferramentas. A segunda colocação significa apenas que o Lumi alcançou a segunda maior média dentro da comparação publicada pelo projeto.
Também não há, até o momento, uma descrição dos dados e procedimentos completos de treinamento. Essa ausência impede avaliar com precisão cobertura linguística, possíveis vieses, tratamento de dados pessoais, riscos de memorização e adequação a setores regulados.
O modelo pode ser baixado pelo comando informado na página oficial, mas o card ainda não oferece um exemplo completo de inferência. Quem pretende testar localmente precisa considerar que os arquivos ocupam aproximadamente 8 GB e que o consumo real de memória tende a ser maior durante a execução, dependendo da biblioteca, do contexto e da precisão escolhida.
O que conferir antes de adotar
Para desenvolvedores e empresas, a principal contribuição do lançamento é oferecer mais uma opção compacta para experimentos em português. Antes de colocar o Lumi IA em um produto, porém, vale usar uma verificação prática:
- Licença: o repositório não exibe uma licença no card atual. Disponibilidade para download não significa automaticamente permissão para uso comercial, modificação ou redistribuição.
- Procedência: aguarde ou solicite informações sobre modelo-base, dados, etapas de treinamento e filtros aplicados.
- Qualidade: teste com exemplos reais do seu domínio e compare respostas factuais, formato, latência e custo de infraestrutura.
- Segurança: mantenha revisão humana em tarefas sensíveis e avalie respostas incorretas, conteúdo impróprio e exposição de dados.
- Reprodutibilidade: confira se os responsáveis publicam scripts e configurações que permitam repetir os benchmarks.
Esse cuidado é especialmente importante porque o termo “aberto” pode se referir a pesos disponíveis, código acessível ou licença permissiva, conceitos que não são equivalentes. Até que os termos sejam publicados, a descrição mais precisa é a de um modelo com pesos disponíveis para download.
O movimento também se conecta ao interesse por modelos que possam ser executados em infraestrutura própria. Em outro exemplo dessa tendência, o Turbo Automate IA mostrou como o Muse Spark Open exige hardware de grande capacidade, enquanto modelos menores podem reduzir a barreira inicial, sem eliminar os custos de validação e operação.


Leave a comment