
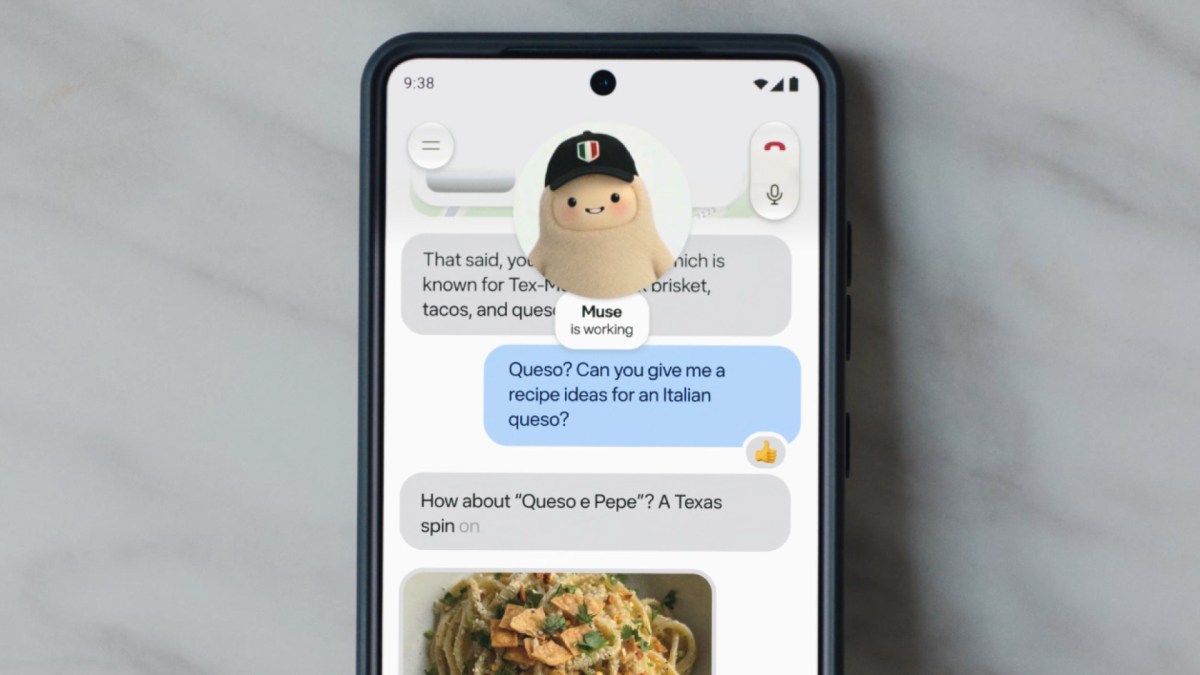
A Meta começou a liberar conversas por voz e avatares expressivos no Meta Muse, seu assistente de inteligência artificial. A atualização importa porque transforma a interação, antes concentrada em texto, em uma conversa contínua na qual a voz, os movimentos labiais e as expressões do personagem são gerados de forma sincronizada.
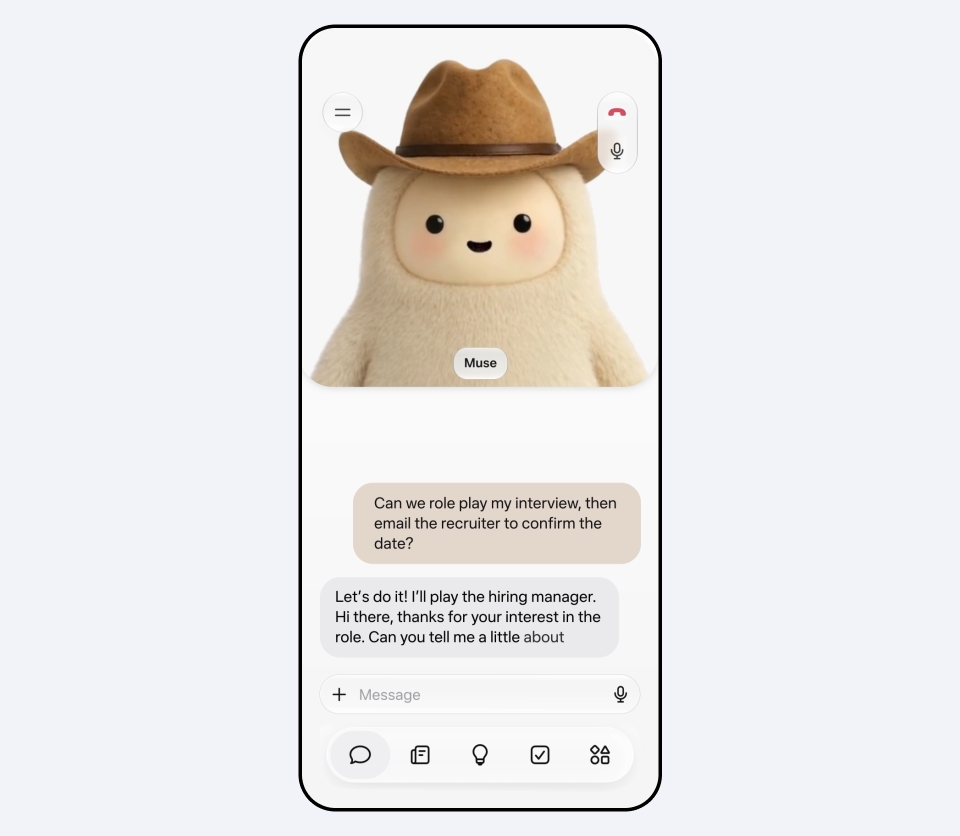
O recurso está chegando inicialmente aos Estados Unidos no aplicativo Muse para celular, web e Mac. A empresa também afirma que as conversas por voz serão levadas futuramente aos óculos com IA e ao dispositivo Muse Charm. Não há, no anúncio, uma data de disponibilidade para o Brasil.
Meta Muse ganha uma interface mais próxima de uma conversa
O novo modo pode ser iniciado pelo ícone de telefone no aplicativo. Segundo a publicação oficial da Meta, a proposta é permitir que a pessoa desenvolva uma ideia falando, sem precisar estruturar cada pedido como um comando escrito.
Entre os exemplos apresentados estão planejar viagens, preparar entrevistas de emprego, ensaiar apresentações e discutir uma proposta. O assistente pode continuar processando a tarefa enquanto o usuário caminha ou realiza outra atividade. A conversa também aceita interrupções, característica importante para que a experiência não fique presa a uma sequência rígida de pergunta e resposta.
O avatar pode aparecer ao lado da conversa ou ocupar a tela inteira. A Meta diz oferecer centenas de opções de voz, com estilos que podem ser trocados pelo usuário. Expressões e gestos variam conforme o tom da fala, mas a qualidade percebida dependerá de fatores como latência, naturalidade da animação e consistência visual durante diálogos longos.
Como voz e avatar funcionam no Meta Muse
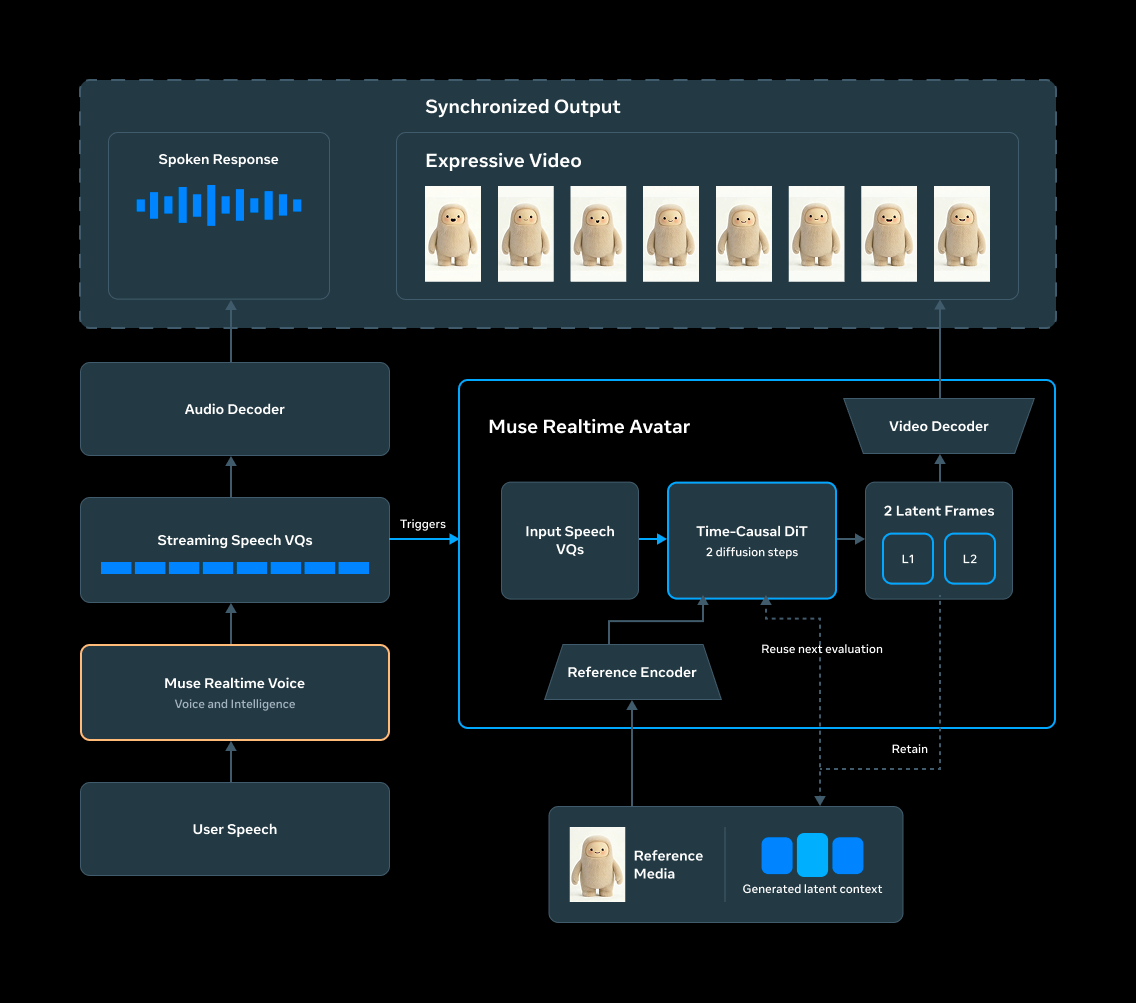
A explicação técnica da Meta descreve um sistema de streaming que conecta inteligência conversacional, voz e representação visual. O Muse Realtime Voice produz tokens de fala que carregam tanto o conteúdo quanto a forma de entrega. Um decodificador transforma esses tokens em áudio, enquanto o Muse Realtime Avatar usa o mesmo fluxo para gerar a animação correspondente.
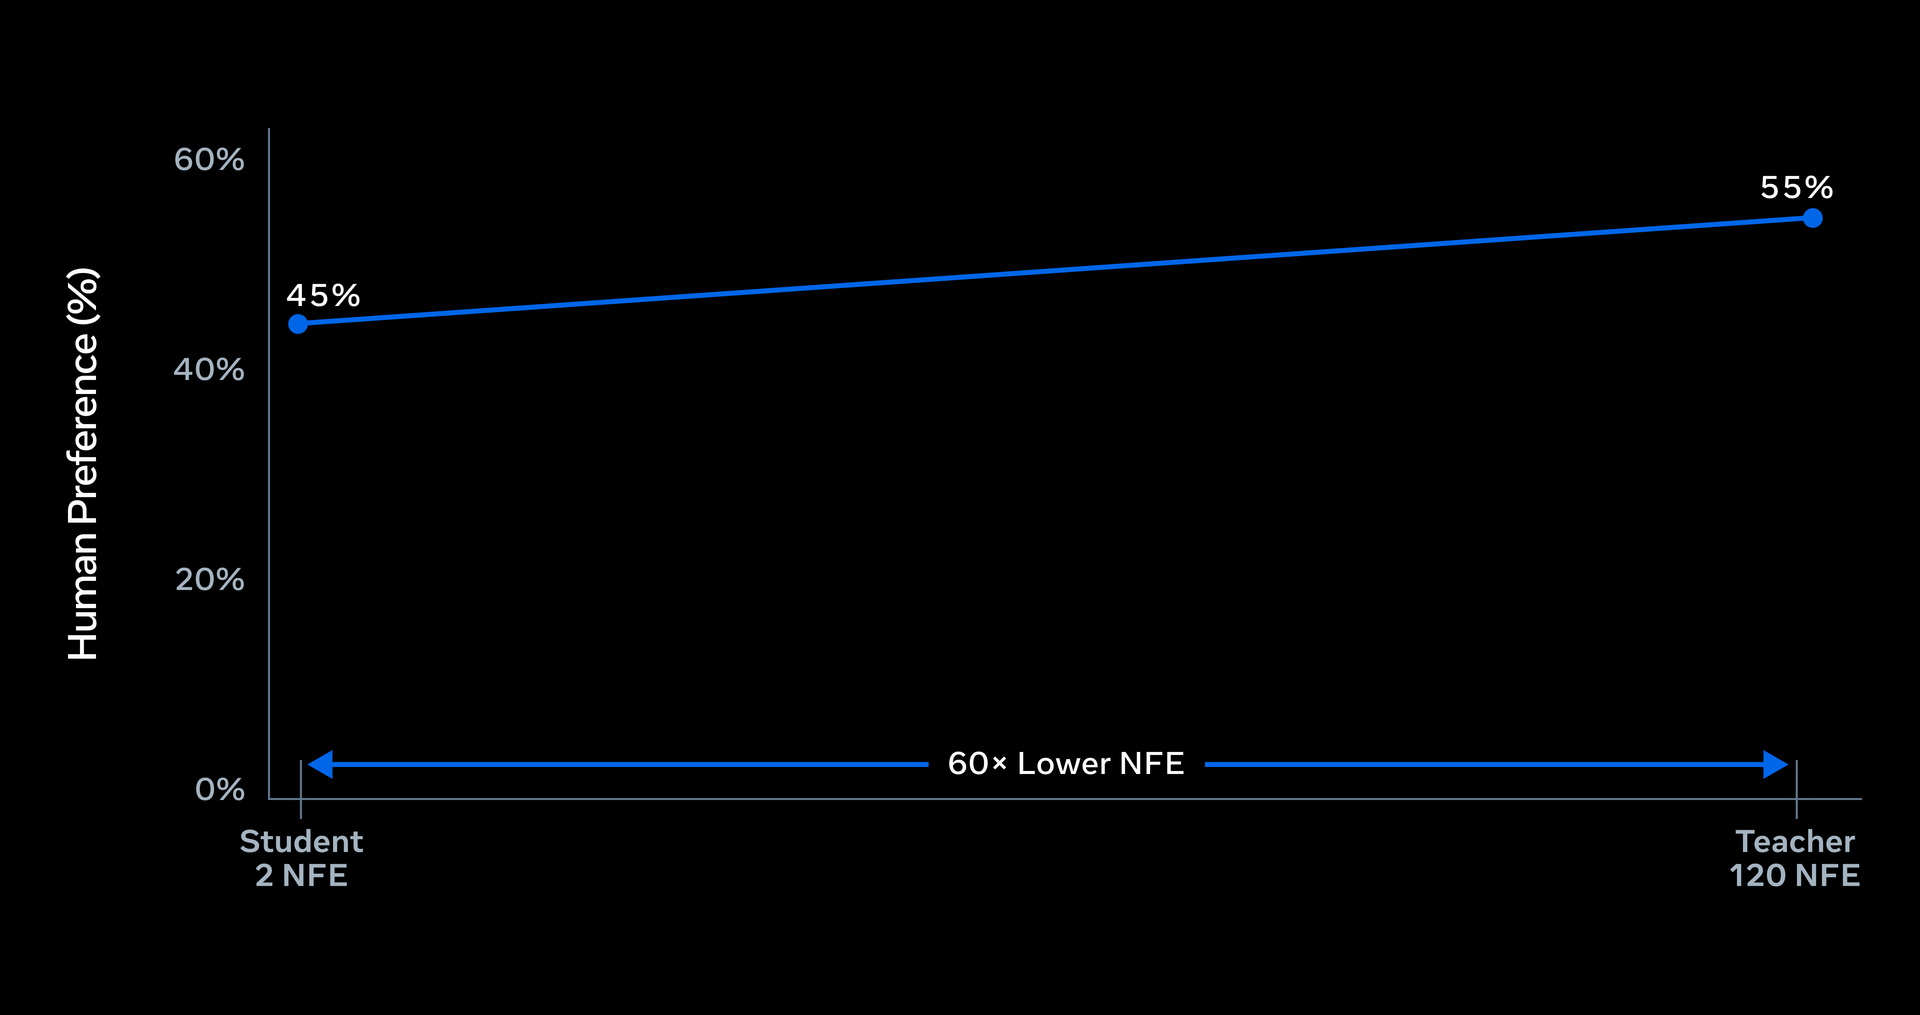
O compartilhamento desse sinal ajuda a manter voz, movimentos labiais e expressões sincronizados. O avatar é gerado por um Diffusion Transformer condicionado pela fala, por uma imagem de referência e por uma janela móvel dos quadros recentes. Em vez de criar um vídeo inteiro antes de exibi-lo, o sistema produz pequenos blocos em sequência e reaproveita o contexto visual anterior.
A empresa informa que o sistema transmite vídeo vertical de 448 por 768 pixels a 25 quadros por segundo, com cerca de 870 milissegundos entre o fim da fala do usuário e o primeiro dado da resposta sincronizada. Os números são medições divulgadas pela própria Meta e não equivalem a uma avaliação independente em redes, aparelhos e condições variadas.
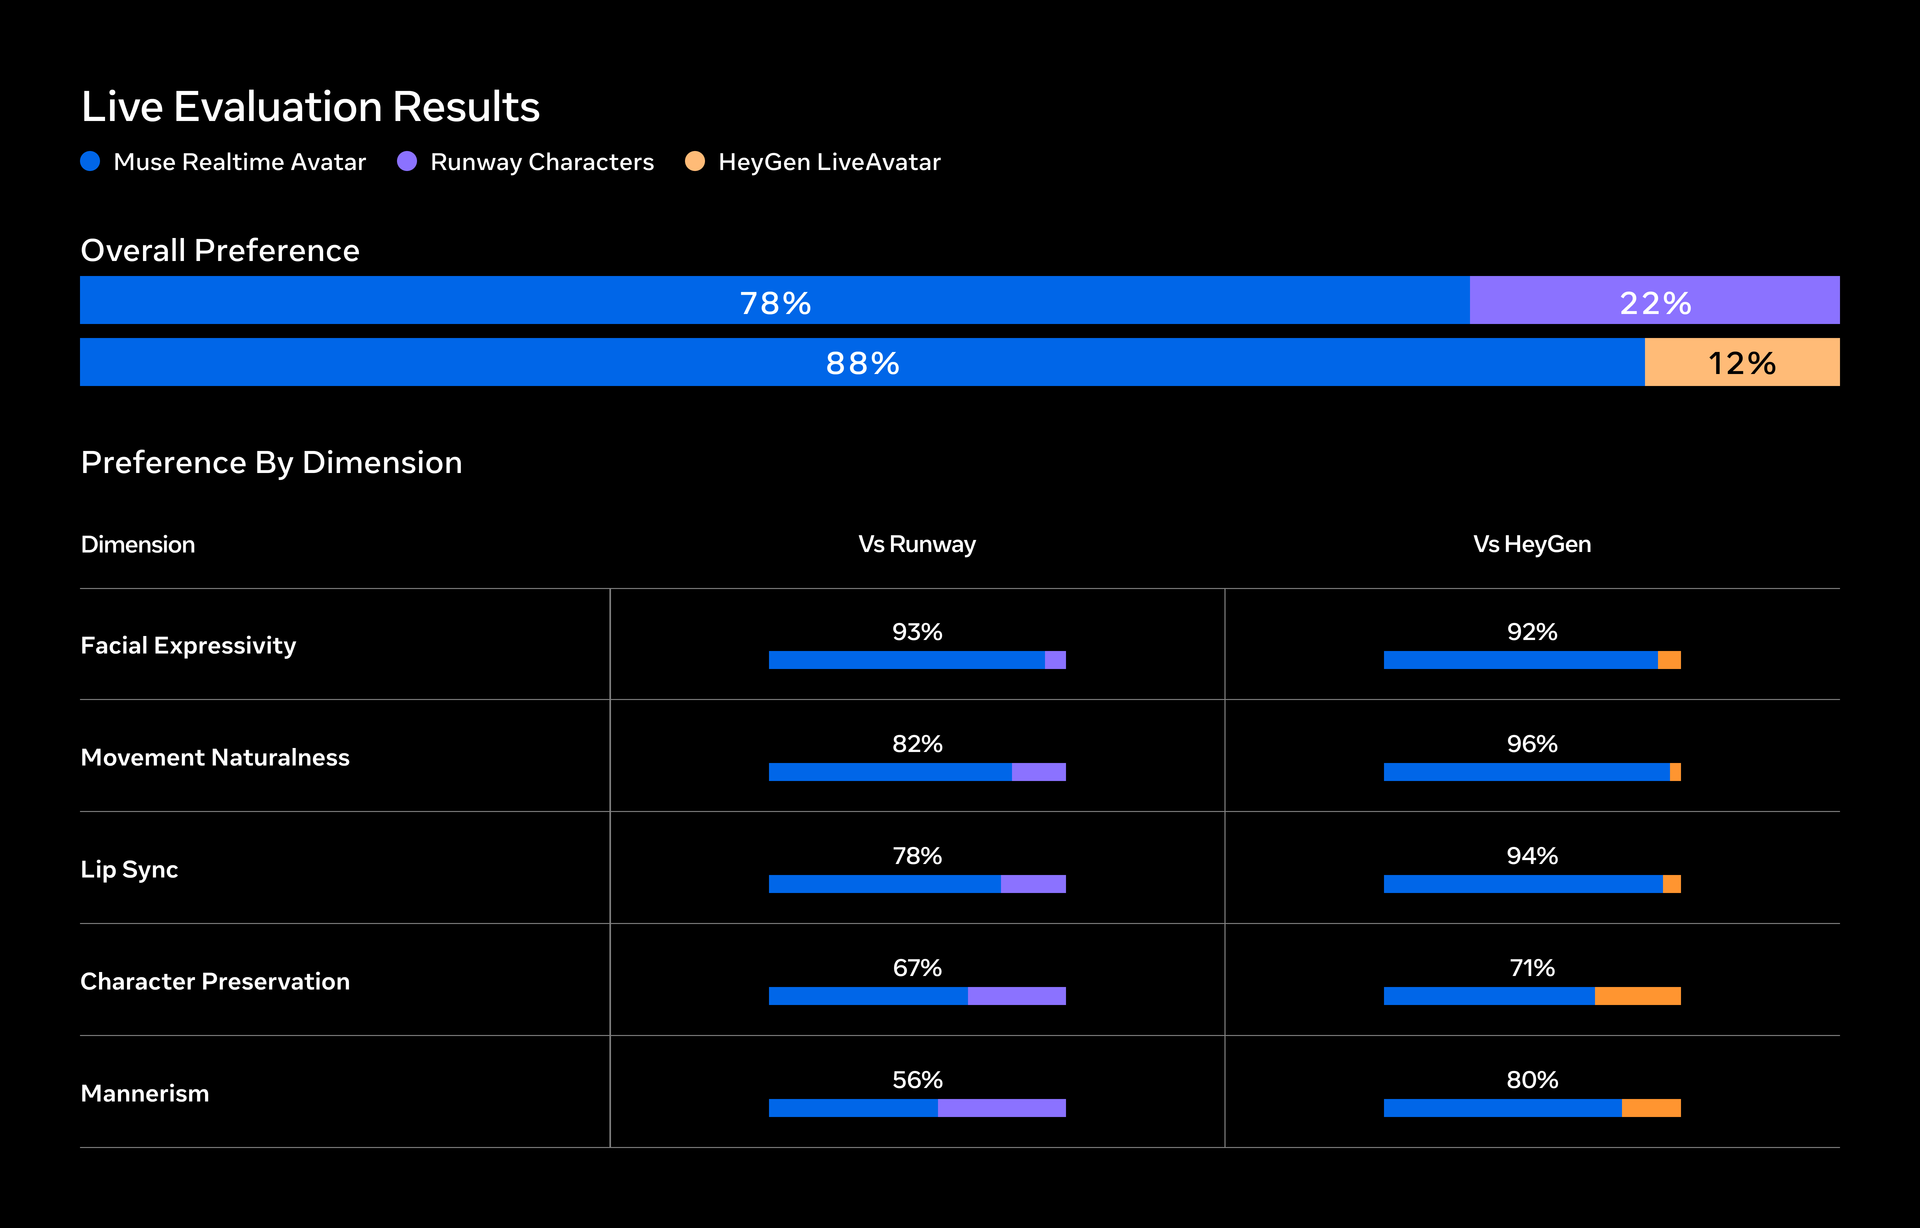
O que muda na prática
O principal avanço não é apenas falar com um chatbot. Modos de voz já existem em outros assistentes. O diferencial proposto pelo Meta Muse é unir a resposta falada a um personagem visual que reage durante a conversa, criando uma interface potencialmente mais adequada para ensaios, treinamento, atendimento e experiências guiadas.
| Uso | Ganho possível | Ponto de atenção |
|---|---|---|
| Entrevistas e apresentações | Prática oral com respostas imediatas | O feedback da IA não substitui avaliação humana especializada |
| Planejamento e brainstorming | Registro de ideias sem interromper outra atividade | Informações e decisões ainda precisam ser verificadas |
| Atendimento e treinamento | Personagem visual pode tornar a experiência mais envolvente | Empresas precisam avaliar privacidade, consentimento e custo |
| Dispositivos vestíveis | Interação sem depender continuamente da tela | A expansão para óculos e Charm ainda foi anunciada como futura |
Para profissionais e empresas, a mudança relevante é de desenho de experiência: o assistente deixa de ser apenas uma caixa de texto e passa a ocupar voz, imagem e contexto em tempo real. Isso pode abrir aplicações em educação corporativa, vendas e suporte, mas também aumenta a necessidade de transparência sobre quando o interlocutor é sintético. A Meta afirma usar o Video Seal, uma marca d’água invisível, para ajudar a identificar a mídia gerada.
A novidade também reforça o movimento de interfaces de IA por voz. O Turbo Automate IA já mostrou como a aquisição da Daily pela Deepgram ampliou a infraestrutura voltada a agentes conversacionais. No caso do Muse, a aposta vai além do áudio e tenta transformar presença visual em parte central do produto.


Leave a comment