
Uma IA open source local permite executar modelos no próprio computador, sem depender de uma API para cada resposta. A opção interessa a quem trabalha com código, documentos internos ou automações e quer mais controle sobre custos, disponibilidade e circulação dos dados. O ponto decisivo, porém, não é apenas baixar um modelo: é combinar arquivo, mecanismo de inferência e interface de acordo com a memória e a tarefa.
O ecossistema já oferece caminhos para diferentes níveis técnicos. O Ollama simplifica a instalação e o gerenciamento de modelos; o llama.cpp dá mais controle sobre execução e quantização; o Open WebUI acrescenta uma interface de navegador; e o Jan Desktop reúne modelos locais e serviços de nuvem em um aplicativo.
Como funciona uma IA open source local
Há três camadas que costumam ser confundidas. O modelo é o conjunto de pesos treinados, como um LLM voltado a texto, programação ou visão. O runtime é o software que carrega esses pesos e calcula as respostas. A interface é a tela usada para conversar, anexar arquivos e organizar históricos.
O formato também importa. O llama.cpp usa modelos em GGUF, formato comum em distribuições preparadas para computadores pessoais. A quantização reduz a precisão numérica dos pesos para diminuir o arquivo e o consumo de memória. Isso pode acelerar a inferência e viabilizar modelos maiores, mas também pode reduzir a qualidade. Portanto, escolher apenas pelo número de parâmetros é insuficiente.
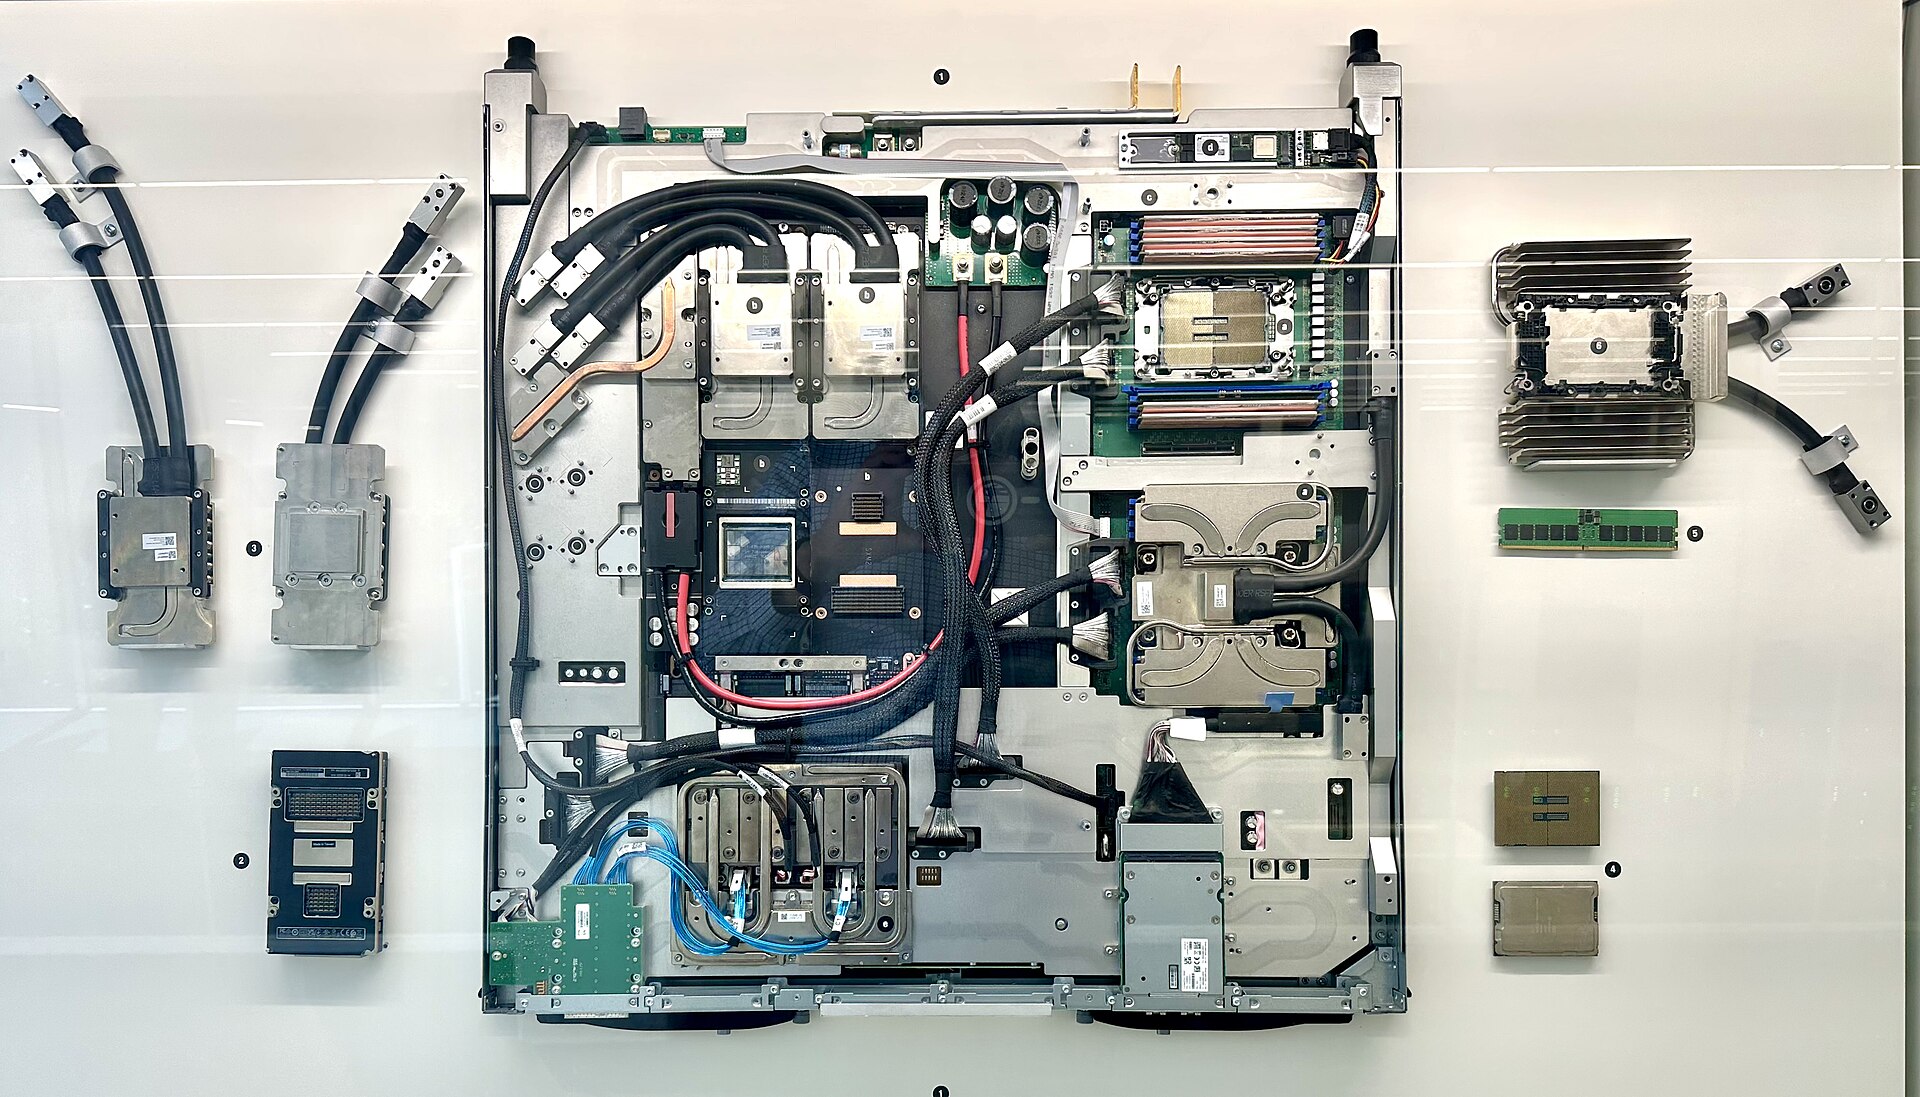
A memória disponível precisa comportar o modelo e a janela de contexto usada na conversa. Contextos maiores guardam mais texto, mas elevam o consumo. Uma GPU compatível tende a acelerar a geração; quando parte do processamento fica na CPU, o sistema ainda pode funcionar, porém com menor velocidade. O próprio Ollama alerta que modelos grandes ficam lentos em máquinas sem GPU forte.
IA open source local: quadro de decisão
| Cenário | Caminho inicial | Prioridade |
|---|---|---|
| Primeiro teste em notebook | Jan ou Ollama com modelo pequeno e quantizado | Instalação simples e resposta rápida |
| Chat interno no navegador | Ollama com Open WebUI | Interface, usuários e persistência |
| Integração com aplicativo | Servidor local com API compatível | Automação e controle do endpoint |
| Ajuste fino de desempenho | llama.cpp e diferentes quantizações GGUF | Memória, velocidade e qualidade |
| Documentos sensíveis | Stack totalmente local, sem conectores externos | Mapear toda saída de dados |
Para redação curta, classificação e extração estruturada, um modelo compacto pode ser suficiente. Programação complexa, raciocínio longo e análise multimodal tendem a exigir mais memória e modelos mais capazes. O teste correto usa exemplos reais do trabalho, mede o tempo até a resposta e verifica erros, não apenas uma conversa genérica.
Quem procura um modelo em português pode começar avaliando opções específicas, como a Lumi IA de 4 bilhões de parâmetros, já apresentada pelo Turbo Automate IA. A licença do modelo, a licença do código e as permissões de uso comercial precisam ser conferidas separadamente.
Privacidade local depende da arquitetura completa
Rodar o LLM no computador não torna automaticamente todo o fluxo offline. Interfaces podem consultar atualizações, ferramentas podem chamar mecanismos de busca e conectores podem enviar conteúdo para APIs externas. O Open WebUI, por exemplo, aceita provedores locais e de nuvem; o endpoint selecionado determina onde a inferência ocorre.
Antes de usar dados empresariais, faça um inventário das conexões, desative integrações desnecessárias e teste o sistema sem internet. Verifique ainda onde ficam históricos, arquivos anexados, embeddings e logs. Para equipes, autenticação, backup, atualização e controle de acesso continuam necessários, mesmo que o servidor esteja dentro da rede.
A melhor configuração inicial é pequena e verificável: uma ferramenta, um modelo compatível com o hardware e três tarefas reais. Se a qualidade não bastar, compare outra quantização ou aumente o modelo. Se o desempenho for o problema, reduza o contexto e meça novamente. Essa abordagem evita transformar uma instalação local em um projeto caro antes de provar utilidade.


Leave a comment