
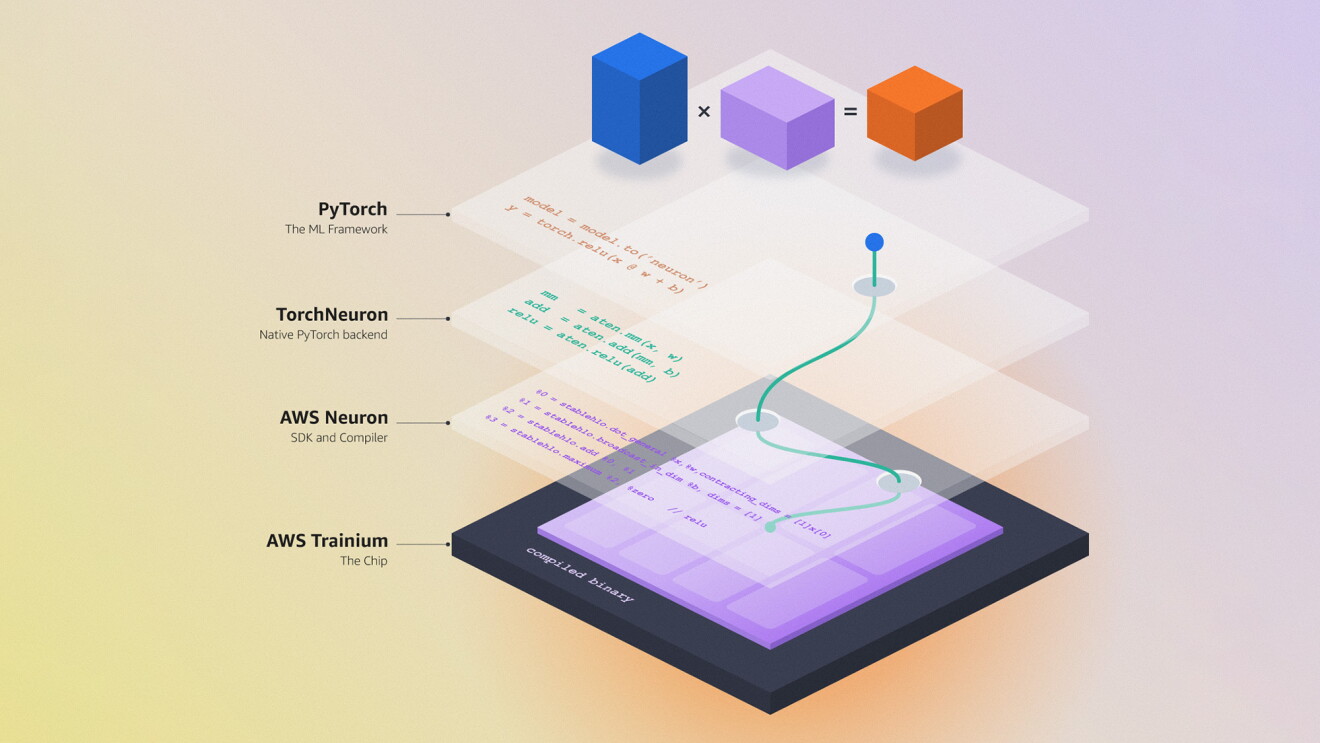
A AWS apresentou o TorchNeuron PyTorch, um backend nativo criado para executar cargas de inteligência artificial nos chips Trainium sem obrigar desenvolvedores a abandonar as interfaces conhecidas do framework. O anúncio importa porque tenta reduzir uma das principais barreiras à adoção de aceleradores alternativos: a necessidade de adaptar código, ferramentas de depuração e rotinas de treinamento para uma pilha específica.
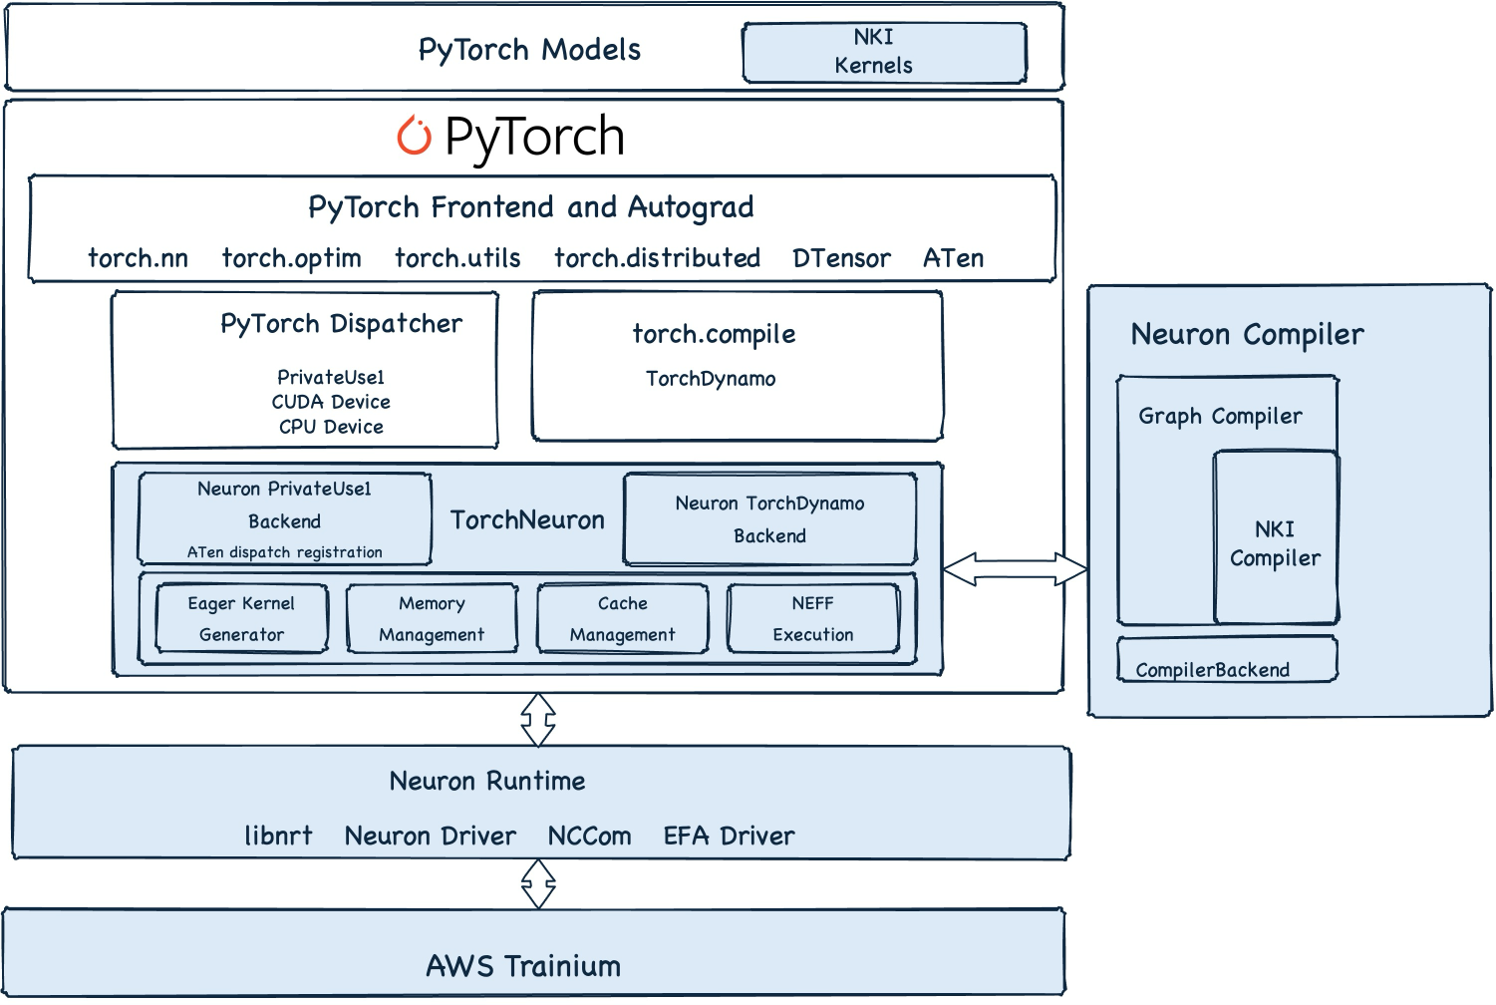
Segundo o anúncio publicado no blog oficial do PyTorch, o TorchNeuron será disponibilizado como código aberto em 20 de outubro. A proposta é integrar o AWS Neuron diretamente ao mecanismo de despacho do PyTorch e ao torch.compile, mantendo APIs como torch.nn, torch.optim e torch.distributed. Na prática, a AWS quer que o Trainium se comporte como um destino mais natural dentro do ecossistema PyTorch.
Como o TorchNeuron PyTorch funciona
O backend liga as operações do PyTorch ao compilador e ao ambiente de execução Neuron. Para o desenvolvedor, isso significa trabalhar com tensores, módulos e ferramentas familiares enquanto a camada inferior traduz e executa as operações no Trainium. A arquitetura também prevê dois caminhos: execução dinâmica para desenvolvimento e depuração, chamada de modo eager, e compilação de trechos maiores por meio do torch.compile.
Esse desenho é relevante porque o ciclo de criação de modelos raramente começa com uma execução longa e totalmente otimizada. Equipes costumam testar formas de tensores, localizar gargalos, alterar camadas e validar resultados antes de compilar o trabalho para produção. Ao oferecer um modo mais interativo, a AWS tenta aproximar essa experiência daquela já usada em CPU e GPU.
O que muda para equipes que usam PyTorch
O impacto imediato não é uma migração automática de qualquer projeto. O ganho potencial está em reduzir o volume de código específico necessário para experimentar o Trainium e em preservar ferramentas conhecidas. A tabela resume a mudança proposta pelo anúncio:
| Etapa | Abordagem anterior | Proposta com TorchNeuron |
|---|---|---|
| Desenvolvimento | Maior dependência de APIs e fluxos específicos do Neuron | Uso mais direto das APIs nativas do PyTorch |
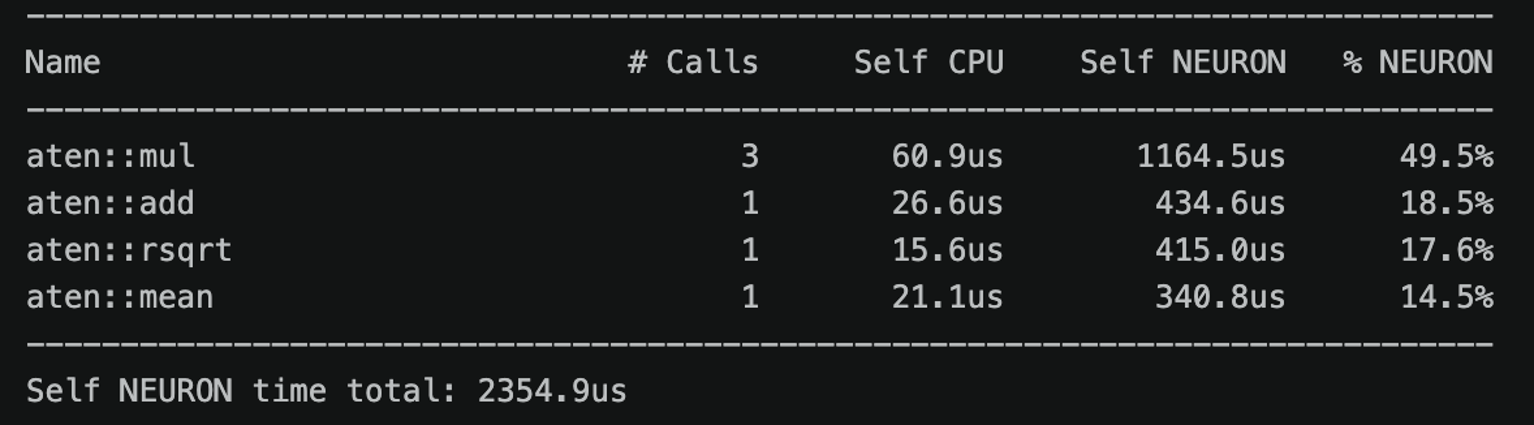
| Depuração | Separação entre o código do framework e a execução no acelerador | Modo eager e integração com o profiler do PyTorch |
| Otimização | Adaptações específicas antes da compilação | Compilação por torch.compile e kernels personalizados via NKI |
| Portabilidade | Mais trabalho para manter caminhos de hardware diferentes | Possibilidade de preservar uma base de código mais próxima entre CPU, GPU e Trainium |
Para empresas, a novidade amplia a opção de comparar custo, disponibilidade e desempenho entre aceleradores sem começar pela reescrita completa da aplicação. Isso pode ser especialmente útil em ambientes que já usam serviços da AWS e querem avaliar instâncias Trainium. A decisão, porém, ainda depende de testes com o modelo real, tamanho dos lotes, comunicação distribuída e requisitos de latência.
Ferramentas de desempenho e limites da novidade
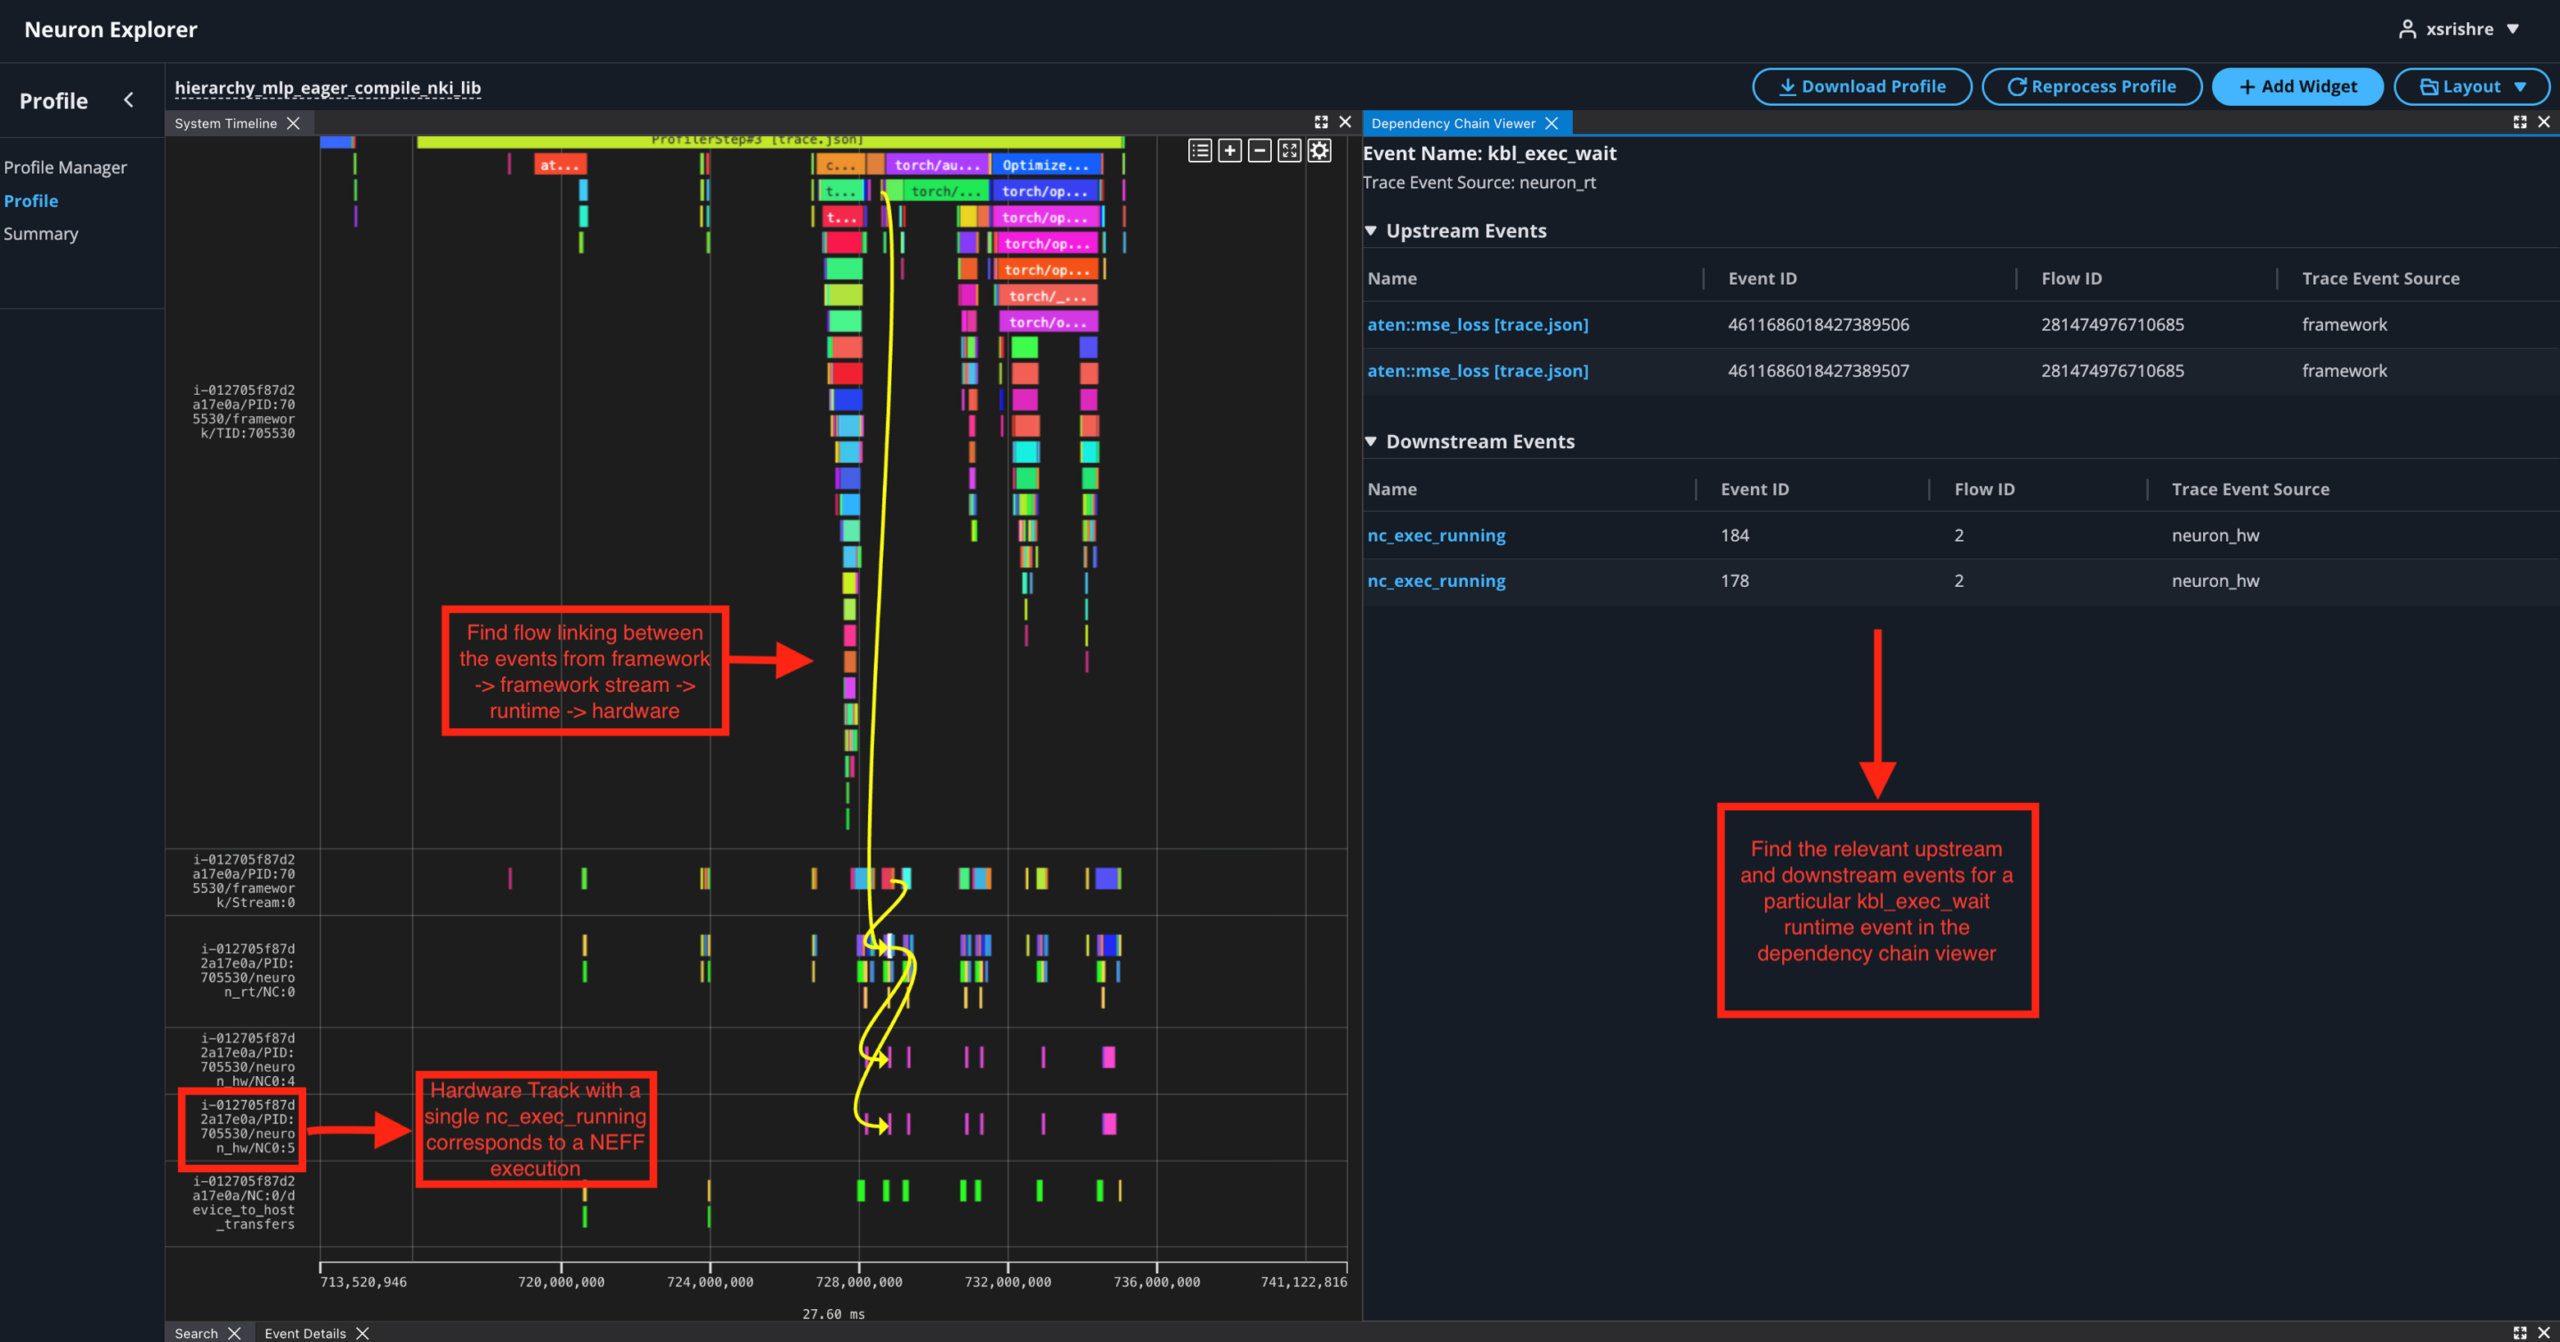
O anúncio destaca integração com o PyTorch Profiler e com o Neuron Explorer. Essas ferramentas permitem relacionar operações do framework com compilação, comunicação, tempo de execução e uso do hardware. A visibilidade é importante para identificar se um gargalo está no modelo, na movimentação de dados ou na forma como as operações foram compiladas.
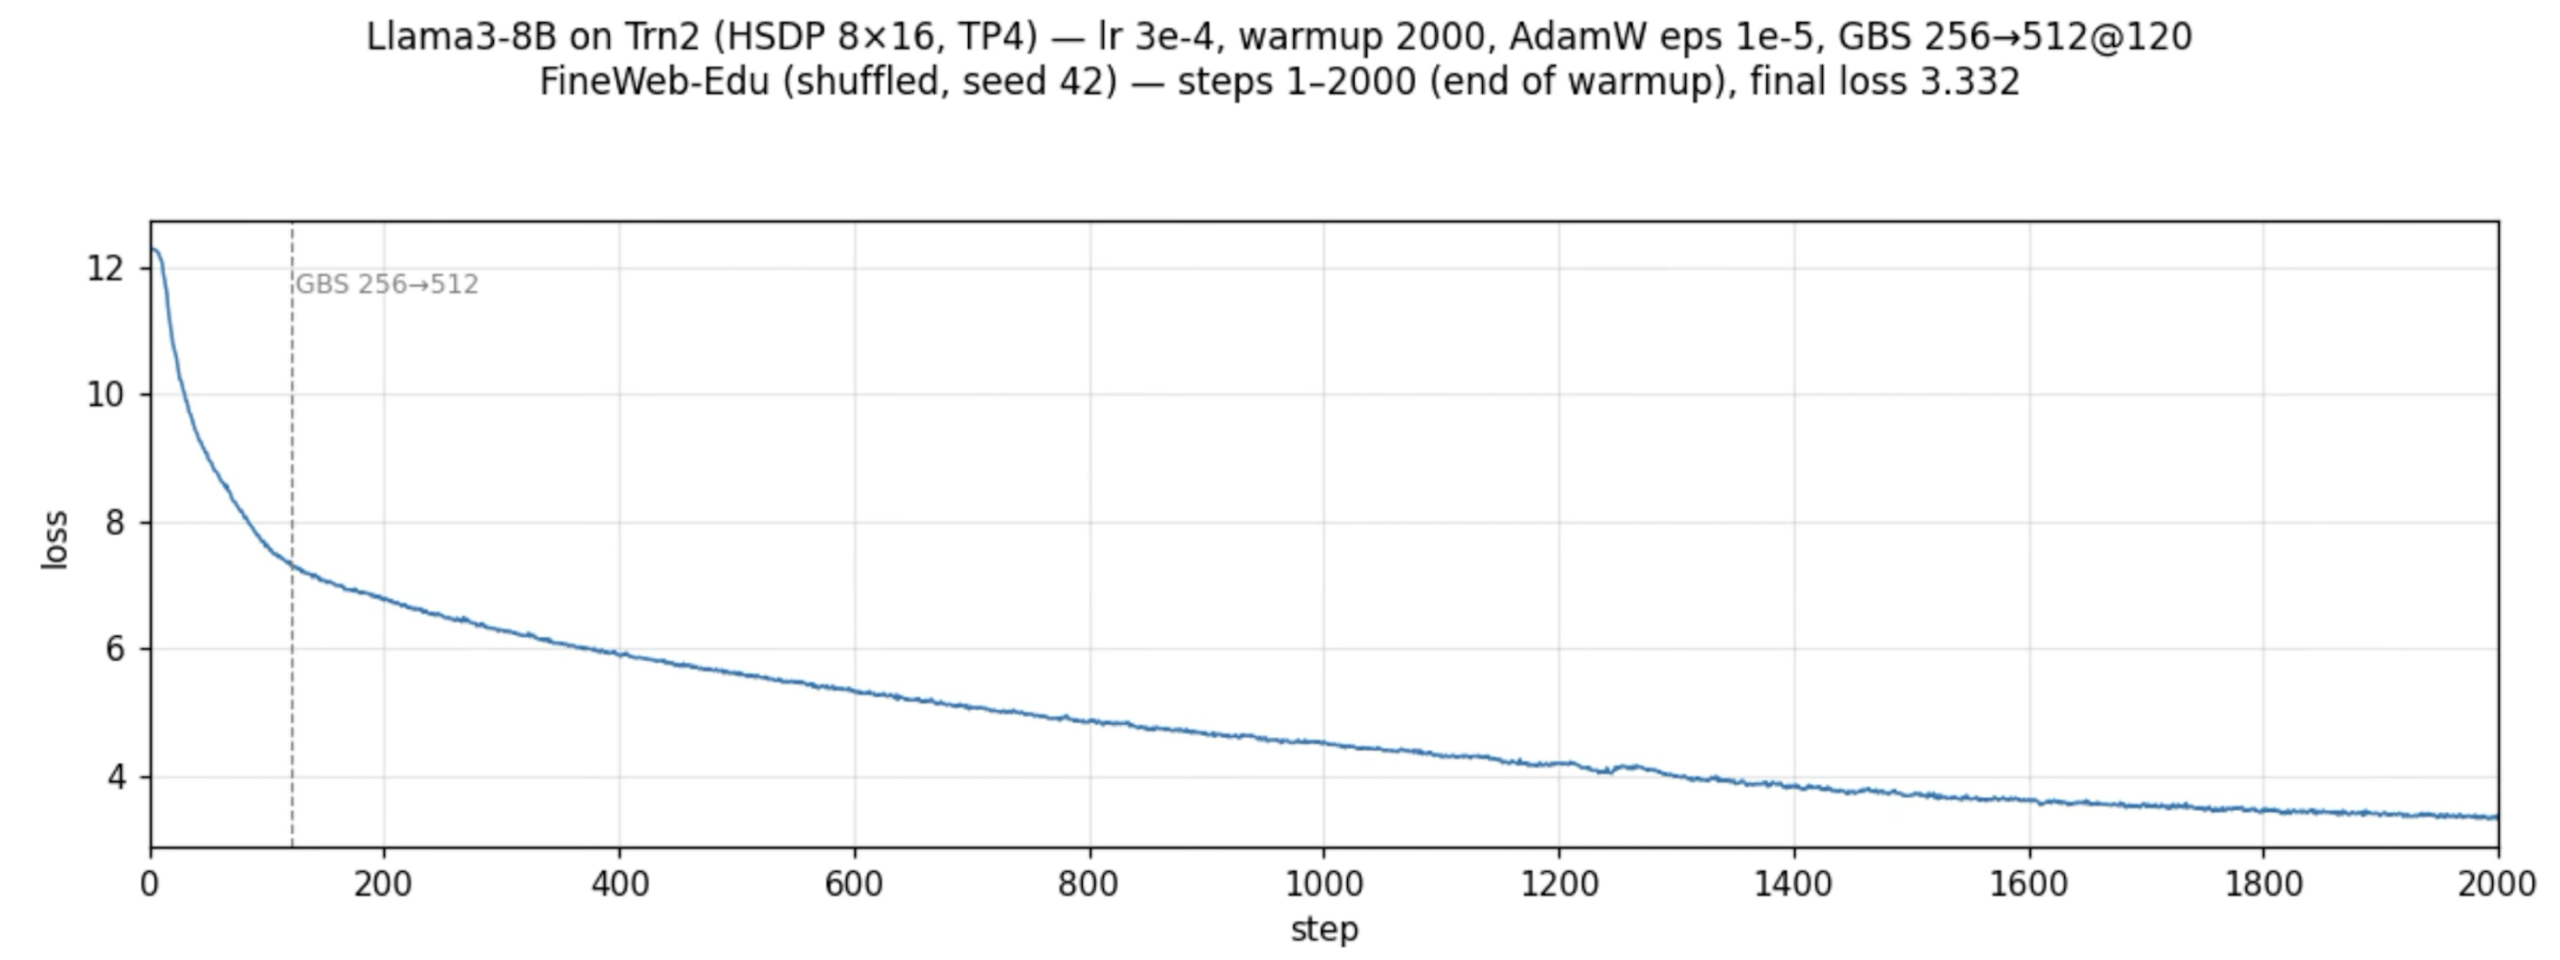
A AWS também informa que o TorchNeuron suporta treinamento distribuído, paralelismo de dados e de tensores, além de kernels personalizados escritos com a Neuron Kernel Interface. Um exemplo divulgado mostra o treinamento do Llama 3 8B em instâncias Trn2, mas esse resultado demonstra compatibilidade técnica, não uma garantia de desempenho para qualquer modelo ou configuração.
Há limites que precisam ser observados. A primeira versão é apresentada como uma prévia, e a própria publicação indica que a AWS continuará ampliando cobertura de operadores, modelos e recursos. Compatibilidade com APIs familiares também não elimina diferenças entre arquiteturas de hardware. Antes de adotar o backend em produção, equipes devem verificar operadores suportados, precisão numérica, estabilidade, ferramentas de implantação e custo total do ambiente.
O movimento aumenta a disputa pela camada de software que conecta modelos aos chips. A Nvidia consolidou uma vantagem não apenas pelo hardware, mas pelo ecossistema de desenvolvimento. Ao aproximar o Trainium do fluxo nativo do PyTorch, a AWS tenta competir justamente nessa camada. Para quem acompanha alternativas abertas, vale observar o ritmo de contribuições, a documentação e a evolução do projeto após a liberação do código. O portal já explicou outra iniciativa de infraestrutura aberta ao analisar a transferência KV no vLLM.


Leave a comment