
A transferência KV no vLLM ganhou um modo push que, segundo testes publicados pela AWS em 19 de outubro, reduziu em até três vezes o tempo até o primeiro token em uma configuração de inferência distribuída. A mudança importa para empresas que operam modelos de linguagem com muitos usuários simultâneos, porque ataca um atraso que aparece entre o processamento do prompt e o início da resposta.
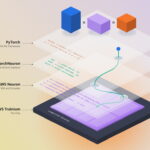
O recurso foi desenvolvido e validado inicialmente em clusters com AWS Trainium e depois contribuído ao vLLM como uma função independente do acelerador. Os resultados divulgados foram obtidos com GPUs em instâncias Amazon EC2 P5en, rede EFA e o modelo Qwen3-32B. Isso mostra o valor do trabalho para o ecossistema aberto, mas não significa que toda instalação verá o mesmo ganho.
Como funciona a transferência KV no vLLM
Na inferência desagregada, a etapa de prefill lê o prompt e monta o cache de chave e valor, conhecido como cache KV. A etapa de decode usa esse material para gerar a resposta token por token. Separar as duas fases permite dimensionar cada uma de forma diferente, mas cria a necessidade de mover o cache entre servidores antes que a geração comece.
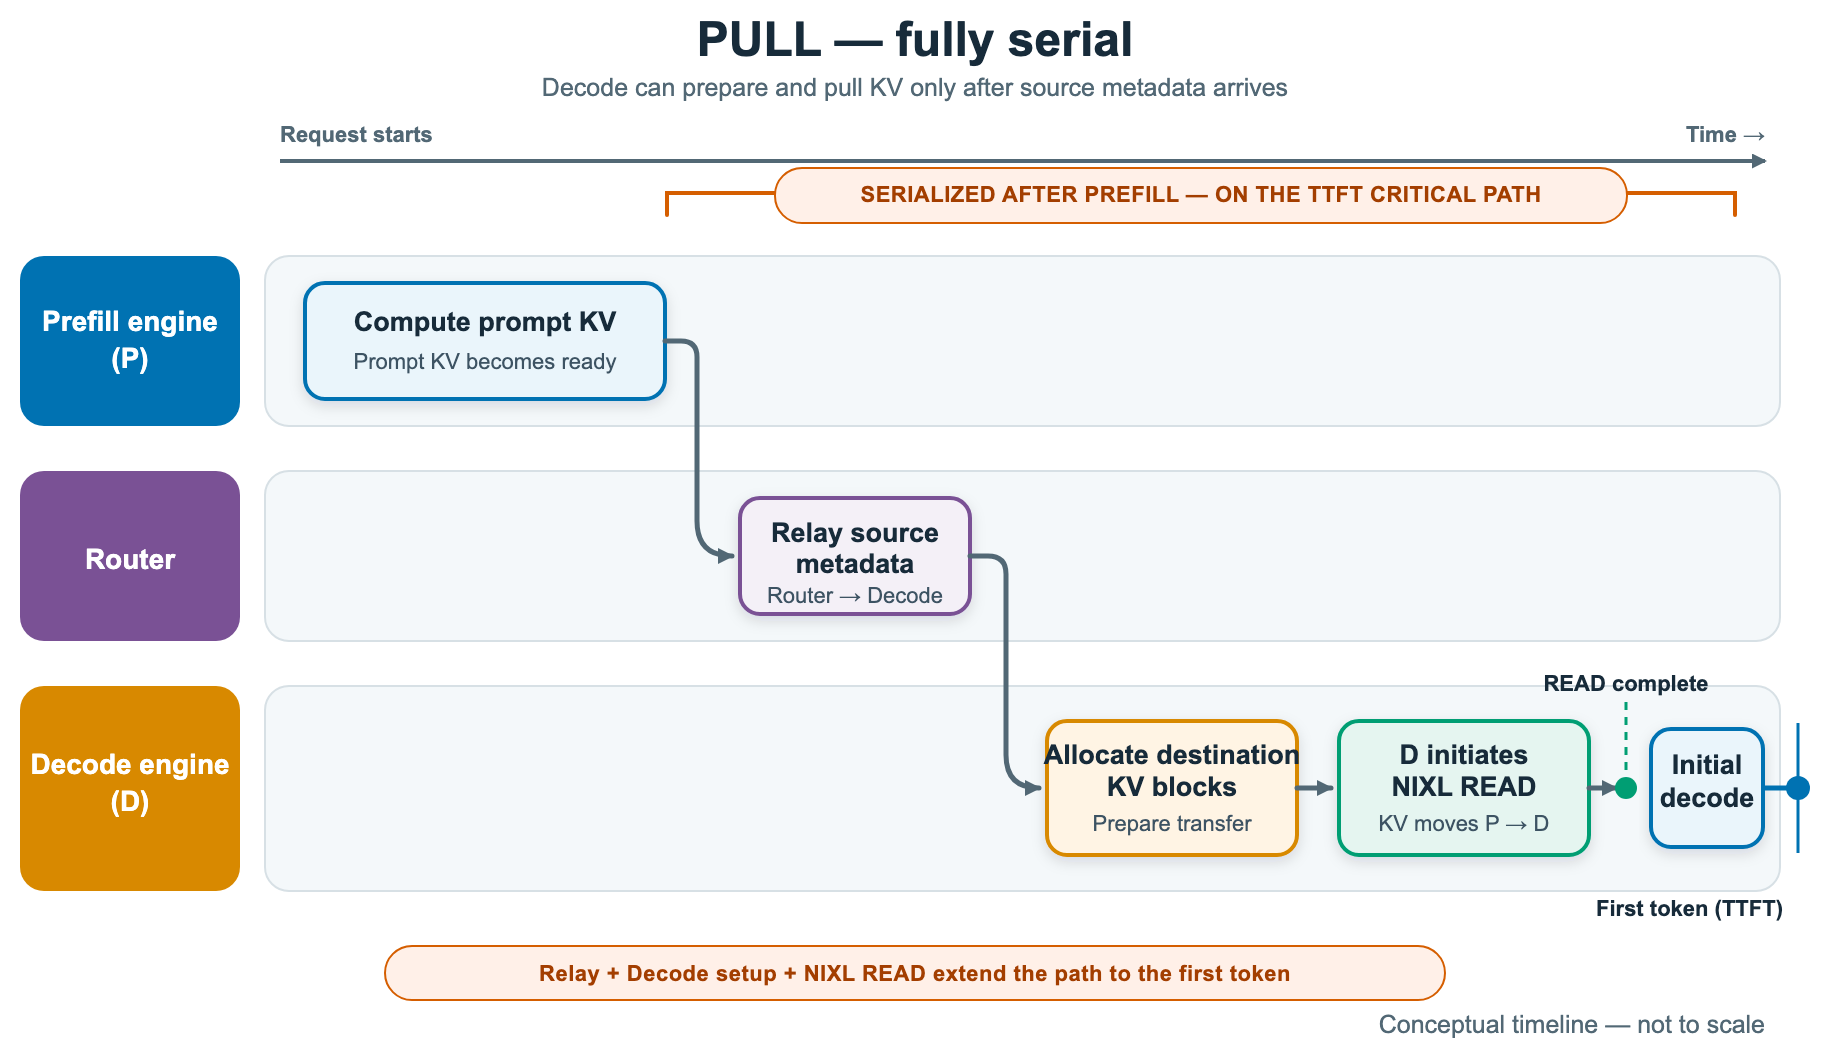
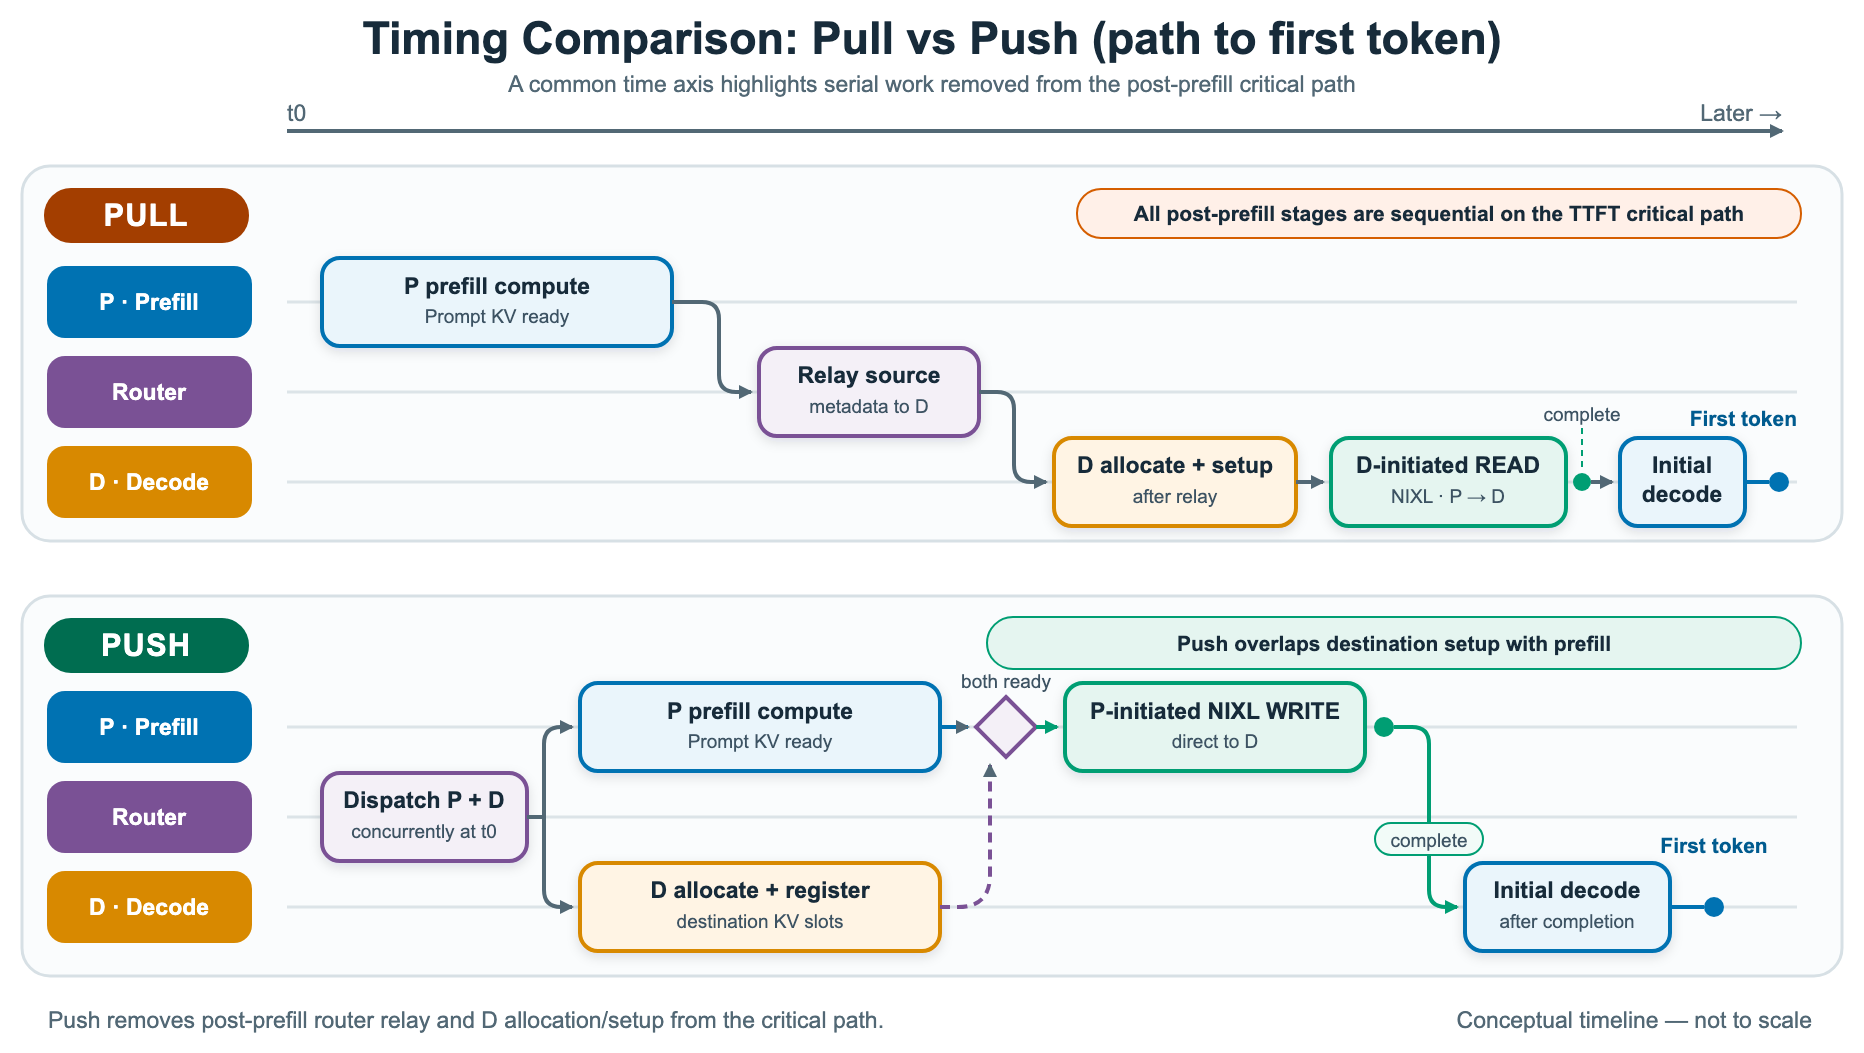
No modo pull tradicional, o servidor de decode espera o prefill terminar, recebe os metadados, reserva os blocos de destino e então busca o cache. Essas tarefas entram em sequência no caminho crítico. No novo modo push, o decode registra antecipadamente onde os dados devem ser gravados. Assim que o prompt e o destino estão prontos, o servidor de prefill envia os blocos por NIXL, enquanto uma thread em segundo plano prepara e submete a transferência.
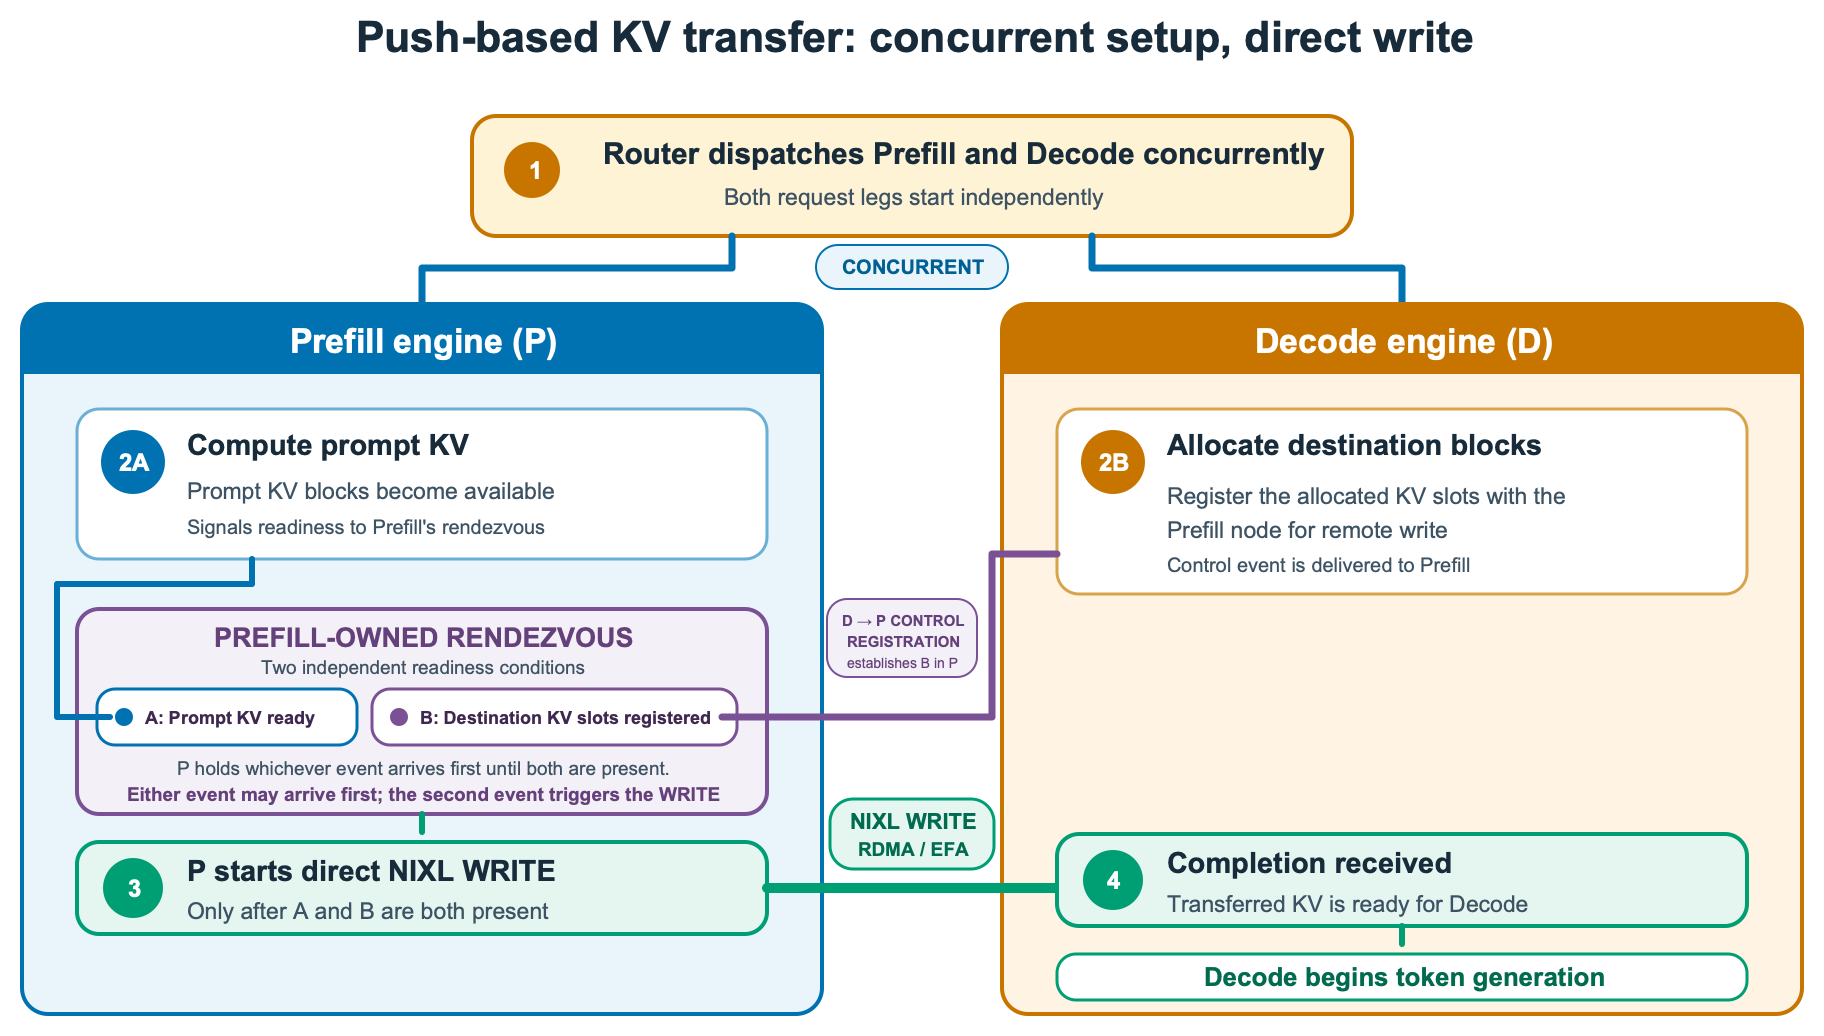
O ganho vem da sobreposição de trabalho. A preparação no lado do decode ocorre enquanto o prefill ainda está calculando, e a montagem dos descritores de transferência deixa de disputar tempo com a geração de tokens. A documentação oficial do conector NIXL push detalha esse fluxo.
O que os testes da AWS mostraram
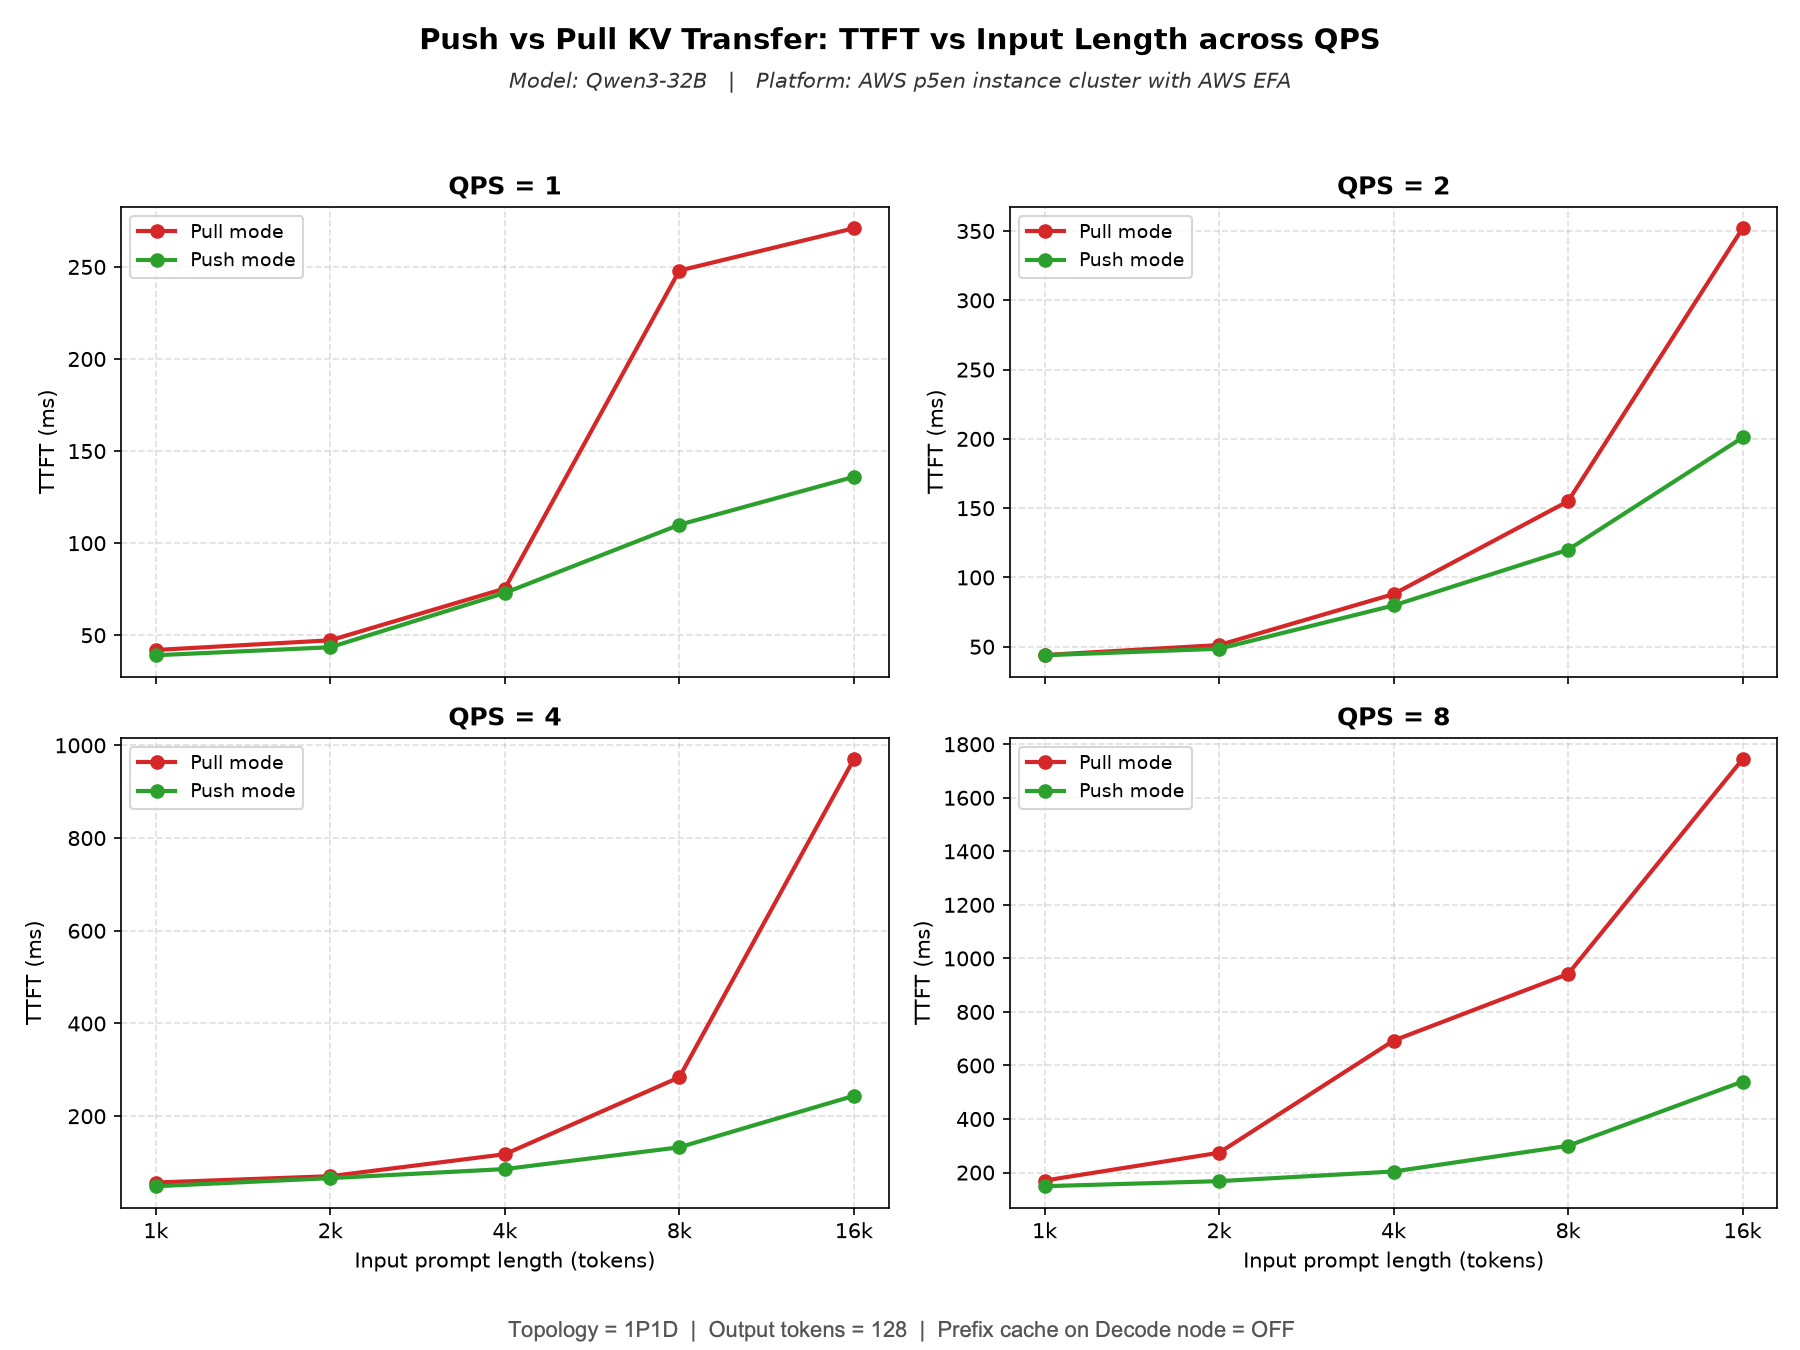
A avaliação usou uma topologia com um nó de prefill e um nó de decode, prompts de 1 mil a 16 mil tokens, taxas de uma a oito consultas por segundo e cache de prefixo desativado. Essa última escolha força a transferência completa do cache KV em cada solicitação e ajuda a isolar o efeito do mecanismo.
Com carga leve e prompts curtos, push e pull ficaram próximos. A diferença aumentou com contextos longos e mais requisições. No cenário de 16 mil tokens e oito consultas por segundo, o tempo até o primeiro token ficou em cerca de 540 milissegundos no modo push, contra aproximadamente 1.744 milissegundos no pull. A AWS também registrou melhora de até 30% no tempo por token de saída.
Os números são promissores, mas representam um ambiente específico. Modelo, hardware, rede, concorrência, tamanho do prompt e configuração do cache alteram o resultado. A própria publicação fornece um guia de reprodução, o que permite comparar a novidade com a carga real de cada equipe.
O que muda para equipes de IA
O principal efeito prático é ampliar as opções para reduzir latência sem trocar o modelo. Antes de adotar, vale comparar os dois modos com métricas de aplicação, não apenas com um teste sintético.
| Critério | Modo pull | Modo push |
|---|---|---|
| Escolha do nó de decode | Pode ocorrer depois do prefill | Precisa ocorrer mais cedo |
| Caminho até o primeiro token | Inclui busca e preparação sequenciais | Sobrepõe preparação e cálculo |
| Melhor encaixe | Roteamento tardio e transferência bidirecional | Prioridade em menor latência sob carga |
| Validação necessária | TTFT, tempo por token, vazão, custo e estabilidade na carga real | |
Há uma troca arquitetural. O push escolhe o destino mais cedo, reduzindo a flexibilidade para decisões tardias de balanceamento. O pull continua indicado quando o roteador precisa observar o estado após o prefill ou quando a aplicação depende de transferência KV bidirecional. Menor latência também não garante redução da conta de infraestrutura, por isso custo por solicitação e utilização dos aceleradores devem entrar na análise.
A contribuição reforça como otimizações abertas de infraestrutura podem mudar a experiência percebida sem lançar um novo LLM. Ela também se conecta à disputa pelo custo de computação, discutida na matéria sobre a dívida da CoreWeave e a corrida por IA. Para equipes que já usam inferência desagregada, o próximo passo racional é reproduzir o teste com seus próprios prompts e limites de serviço.


Leave a comment